 English
 Suomi
 Deutsch
 Polski
Vous souhaitez automatiser vos tâches courantes ?
Contactez-nous dès aujourd’hui pour améliorer l’expérience client et la productivité.
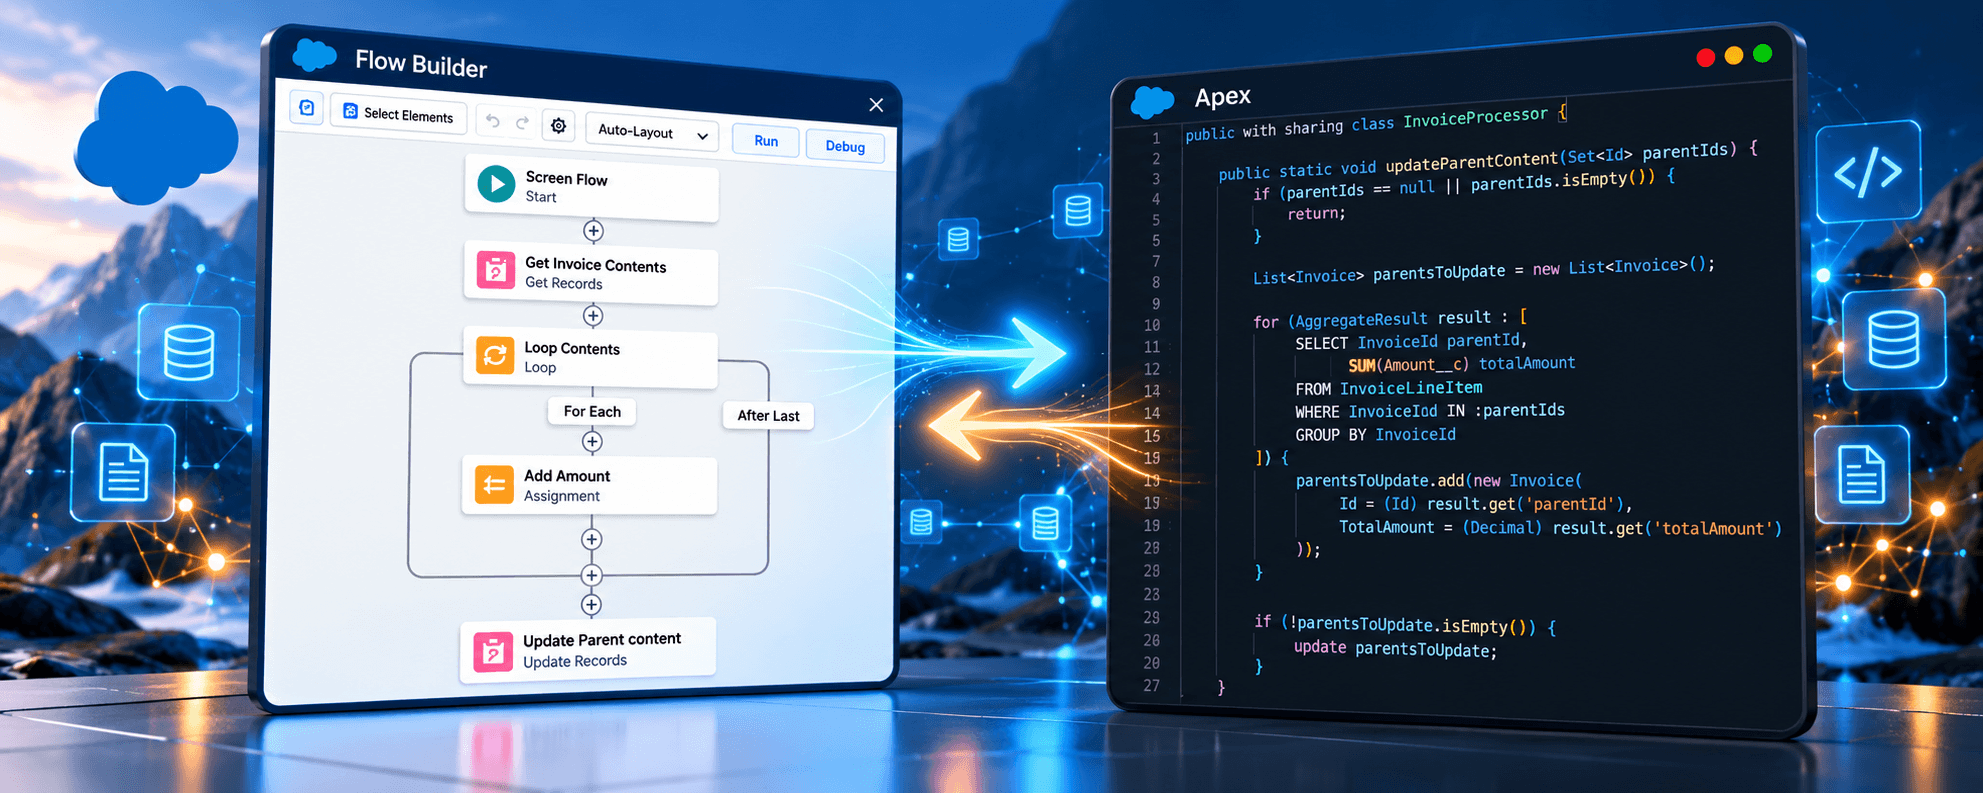
Récemment, je me demandais pourquoi Flow reste presque systématiquement considéré comme le premier choix pour mettre en œuvre une fonctionnalité dans Salesforce.
Flow est disponible en standard. C’est un outil visuel et structuré. Les couleurs sont belles. Il est présenté comme un outil dont les administrateurs peuvent assurer la maintenance. Apex, en revanche, est souvent critiqué pour sa très grande complexité, son caractère très spécifique, son coût de mise en œuvre élevé et sa maintenance difficile.
Dans de nombreux articles comparant Flow et Apex, Flow est présenté par défaut comme la meilleure option. Les mêmes avantages reviennent : il est plus simple, plus facile à maintenir, nécessite moins de compétences techniques et constitue généralement l’approche recommandée.
Je me suis demandé si cette position était encore valable aujourd’hui. Avec les outils de programmation assistée par IA et de vibe coding, de nombreux arguments historiques contre Apex ont perdu de leur force. En parallèle, je pense que Flow est souvent présenté comme bien plus simple qu’il ne l’est réellement.
Mon idée principale est simple : Apex n’est pas si difficile, et les flux ne sont pas si faciles. Leur complexité est bien plus comparable qu’on ne le suppose généralement.
Commençons par les flux. Ils comportent de nombreuses structures que l’on retrouve dans Apex : itérations, requêtes, actions, conditions, affectations, etc.
Vous devez généralement savoir comment construire une application et un algorithme. Un flux est un algorithme, au même titre que le code.
En arrière-plan, Flow est une représentation XML de cet algorithme, tandis qu’Apex est un langage de programmation qui représente lui aussi un algorithme. Dans les deux cas, l’algorithme devient compréhensible par la machine qui l’exécute.
La logique de Flow est-elle simple ? Pas exactement. Elle est représentée visuellement.
Cette représentation visuelle donne l’impression que Flow est plus simple qu’Apex. À mon avis, cette simplicité peut être trompeuse.
Flow permet de réaliser de nombreuses opérations du même type qu’Apex, et vous pouvez combiner Flow et Apex à l’aide d’actions invocables. Ils répondent aux mêmes objectifs dans de nombreux cas et s’exécutent à partir de points d’entrée similaires, notamment les mises à jour d’enregistrements, les planifications et les actions des utilisateurs dans Salesforce.
Sur le plan de la complexité, les flux peuvent sembler plus simples parce qu’ils prennent la forme de diagrammes visuels, tandis qu’Apex demande de savoir lire du code. Mais Flow doit être traité avec autant de rigueur qu’Apex. Pour une introduction, consultez notre présentation de Salesforce Flow Builder.
Lorsque nous disons que les équipes d’administration suffisent pour assurer la maintenance des automatisations, cela peut être vrai, mais à une condition importante. Les personnes qui assurent la maintenance de Flow doivent savoir construire des algorithmes.
Elles doivent avoir un mode de raisonnement qui leur permette de construire des algorithmes étape par étape, de prévoir des solutions de repli en cas d’erreur, d’anticiper les problèmes possibles et de réfléchir aux besoins futurs. Elles doivent également disposer d’un moyen de tester automatiquement ces fonctionnalités.
De toute personne mettant en œuvre de telles automatisations, j’attendrais un raisonnement méthodique et une compréhension de la manière de construire des algorithmes, des systèmes et des applications.
Vous devez être capable de déterminer quelles entrées sont invalides pour l’algorithme, quels résultats vous attendez, quelles erreurs vous pouvez gérer et lesquelles vous ne pouvez pas gérer.
Le low-code ne supprime pas la nécessité de raisonner en termes d’ingénierie logicielle. Le code généré par l’IA ne la supprime pas non plus.
Flow convient parfaitement aux automatisations simples. Si le besoin est : « Lorsque mon opportunité passe au stade Fermée gagnée, envoyer une notification par e-mail », alors oui, vous pouvez tout à fait maintenir cela dans Flow.
Si vous souhaitez proposer à vos agents un processus guidé par une interface utilisateur, Flow convient aussi parfaitement. Si, aujourd’hui, vous voulez envoyer un e-mail promotionnel, créer un flux pour une campagne, puis le désactiver ou le modifier dans trois mois, Flow convient bien. C’est précisément là que Flow est performant.
Mais si vous recherchez quelque chose de plus complexe, comme trouver tous les prospects dont le champ Company ressemble au nom du compte que vous venez de créer par conversion, puis convertir ces prospects, c’est une autre histoire.
Ma règle personnelle est de commencer à examiner un Flow plus attentivement dès qu’il contient plus d’une dizaine d’éléments. Si le Flow combine des itérations et des requêtes, ou doit interroger, collecter, mapper, regrouper ou analyser des enregistrements, alors, selon moi, il devient déjà complexe. Ce n’est pas une bonne pratique officielle de Salesforce, mais simplement mon propre repère.
À ce stade, en particulier avec du code généré par l’IA, il peut être beaucoup plus facile d’obtenir le même résultat avec Apex. J’éviterais de placer de la logique dans Flow lorsque je dois établir une correspondance entre les valeurs de deux enregistrements, analyser ou regrouper des enregistrements, traiter des données en masse ou gérer une logique impliquant de nombreuses transactions.
Ce n’est pas que Flow en soit incapable : il peut le faire. Mais pouvoir construire quelque chose dans Flow ne signifie pas que Flow soit le meilleur moyen d’exprimer l’algorithme. Un Flow très volumineux peut parfois être remplacé par une petite quantité de code Apex.
Lorsque je dis que les utilisateurs avancés peuvent échouer lamentablement avec Flow, je ne veux pas dire que Flow est mauvais. Ce n’est pas l’outil qui est en cause, mais la manière dont on l’utilise. Le problème se situe entre le clavier et la chaise.
On trouve des implémentations où de nombreux flux actifs et désactivés s’accumulent dans l’organisation, avec des champs inutilisés, des champs en double, des flux en double et de la logique dupliquée. Le système peut encore fonctionner, mais chaque nouveau bug ou problème augmente le coût de maintenance dans cette configuration.
Contrairement à Apex, les flux ne sont pas soumis à des tests unitaires obligatoires. Oui, vous pouvez créer des tests pour couvrir la logique d’automatisation de Flow, mais ce n’est pas obligatoire, et ce qui n’est pas obligatoire est souvent laissé de côté.
Le problème n’est pas que Flow ne peut pas être testé. C’est que Flow peut donner l’illusion que, parce qu’il est visuel, il ne s’agit pas vraiment de code et qu’il ne nécessite pas la même rigueur.
Il doit être traité comme du code. Conventions de nommage, nettoyage, gestion de versions, tests, revue par les pairs et processus de déploiement : tous ces éléments doivent être présents.
La situation est différente avec Apex, où les tests sont obligatoires pour un déploiement en production et où le seuil de couverture du code requis doit être atteint. Un flux peut être déployé sans tests automatisés. Le problème n’est pas que Flow ne peut pas être testé, mais qu’il est plus facile de faire l’impasse sur les tests lorsque la plateforme ne les impose pas.
Du point de vue de la revue par les pairs, Flow peut en réalité être plus difficile à examiner qu’Apex. Si j’ouvre du code Apex dans GitHub, même un développeur Java peut repérer les duplications, les méthodes trop longues, une architecture mal conçue, des conditions et des boucles compliquées, ou une répartition peu claire des responsabilités.
Avec le XML de Flow, c’est beaucoup plus difficile. Même les développeurs Salesforce ne peuvent pas correctement examiner un Flow dans GitHub en lisant seulement son XML : ils doivent l’ouvrir dans son éditeur visuel. Ainsi, même si Flow semble simple dans Salesforce, il peut être moins transparent du point de vue de la gestion de versions et de la revue de code.
Je ne cherche pas à dire qu’Apex devrait désormais être l’approche par défaut pour créer toutes les automatisations Salesforce. J’explore l’idée qu’Apex présente bien plus d’avantages qu’il y a, disons, six ans.
De nombreux arguments historiquement opposés à Apex — complexité, coût de développement et coût de maintenance — ont perdu de leur force. Cela tient principalement aux outils de programmation assistée par IA.
Apex ressemble à Java et à C#. Les personnes qui préfèrent C# y trouveront de nombreuses ressemblances avec C#, et celles qui préfèrent Java le trouveront familier. Disposer d’un langage de programmation qui ressemble à des langages aussi répandus constitue un avantage.
Il existe énormément de code écrit en Java, C#, JavaScript, HTML et dans bien d’autres technologies. Les grands modèles de langage modernes maîtrisent très bien ces langages et, d’après mon expérience, maîtrisent aussi très bien Apex et Lightning Web Components.
Je soupçonne que c’est aussi l’une des raisons pour lesquelles les LLM sont beaucoup moins performants avec les métadonnées Flow : il existe moins de données d’entraînement pour le XML de Salesforce Flow, et il est difficile de trouver de nombreux flux dans les dépôts GitHub publics. C’est une hypothèse de ma part, pas quelque chose que je peux prouver.
D’après mon expérience, les LLM sont nettement meilleurs pour générer de l’Apex que pour générer des métadonnées Flow à partir de zéro. Avec Flow, j’ai constaté des échecs où le modèle simplifie la tâche, crée de nombreuses actions invocables et réduit le flux à guère plus qu’un point d’entrée. J’ai également vu du XML généré qui ne se déployait pas correctement dans Salesforce.
Pour un LLM, modifier un flux existant est plus facile que de créer quelque chose de nouveau dans une organisation vide, mais même dans ce cas, il peut produire des erreurs.
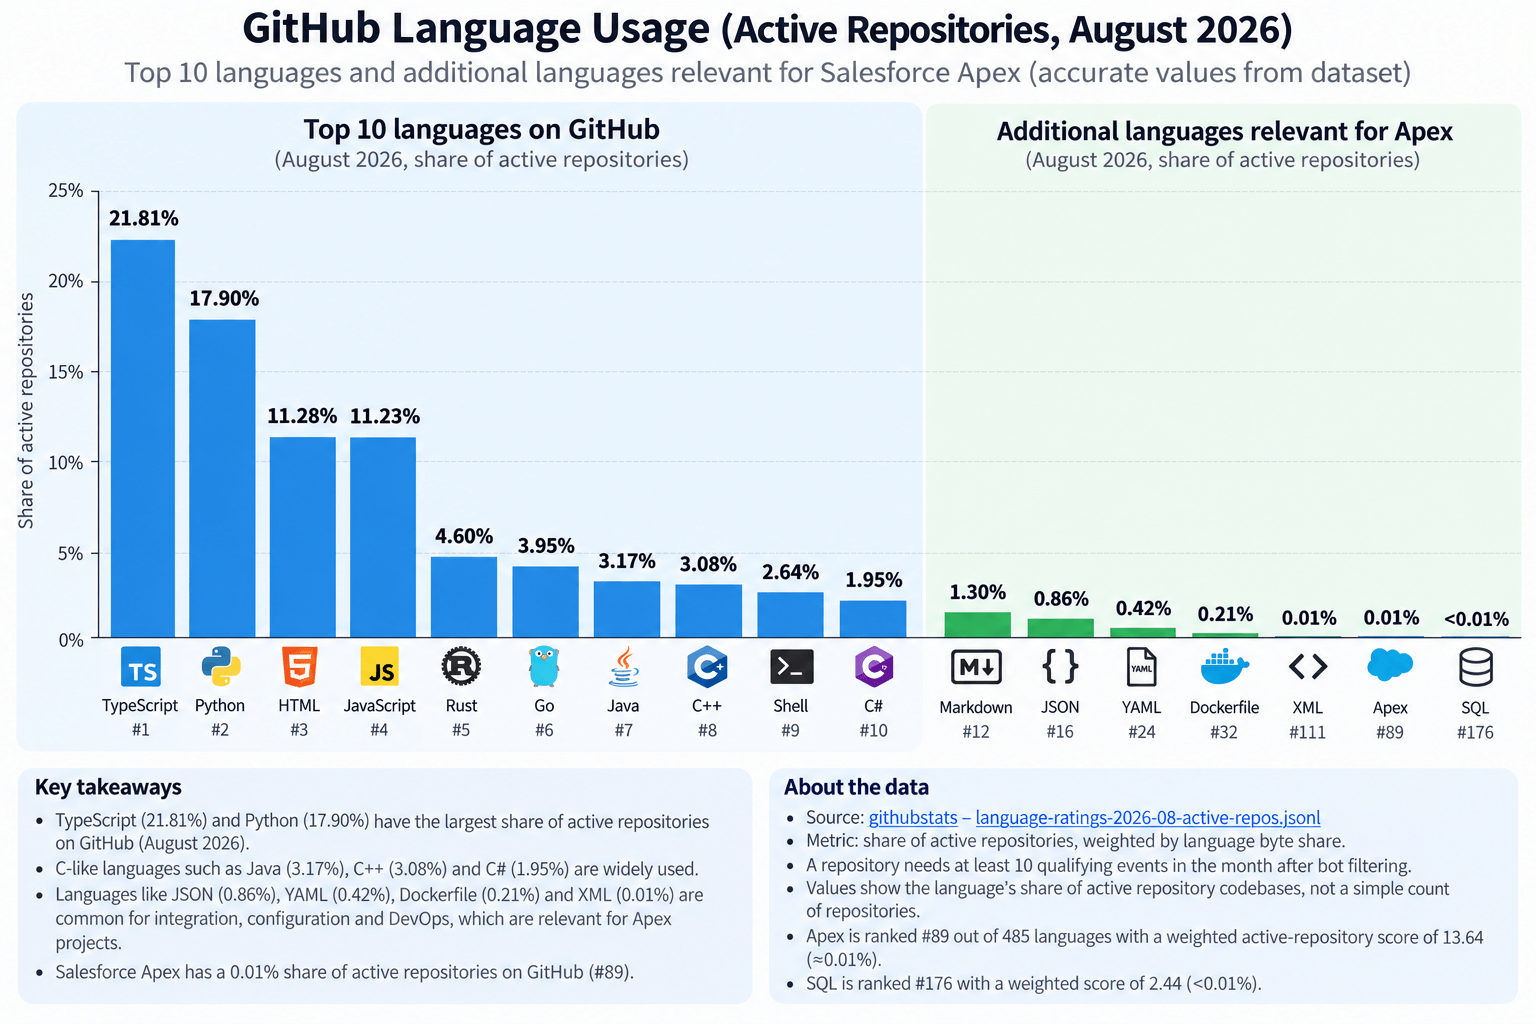
Apex ne représente qu’une très faible part des dépôts GitHub publics actifs par rapport aux langages courants. Cela permet d’illustrer la différence de volume de code publiquement visible, mais ne prouve pas en soi qu’un LLM est plus performant avec Apex ou moins performant avec les métadonnées Flow.
Avec des outils comme Codex, Claude Code ou OpenCode, les développeurs peuvent désormais connecter un LLM directement à un projet de développement ou à une base de code Salesforce.
Le LLM peut retrouver des parties précises de la base de code, identifier des problèmes et des bugs, retracer la logique et générer des modifications bien plus rapidement qu’un développeur ne pourrait le faire manuellement. La génération de code elle-même est également très rapide, ce qui permet aux développeurs de construire et d’itérer beaucoup plus vite.
Mais cela ne supprime pas le besoin de connaissances en ingénierie.
Les développeurs qui comprennent comment concevoir une solution Salesforce peuvent guider le LLM vers les bonnes décisions d’architecture, les bonnes approches de mise en œuvre et les bons modèles de conception du code. Ils peuvent ainsi produire du code propre et fonctionnel sans passer autant de temps à tout écrire eux-mêmes.
Un travail qui pouvait auparavant prendre un mois peut désormais parfois être réalisé en plusieurs jours.
La différence ne tient pas seulement à la rapidité.
Les développeurs peuvent consacrer davantage de temps à ce qui compte vraiment : la logique centrale, l’architecture, les cas limites, l’expérience utilisateur et la maintenabilité. Ils peuvent améliorer l’interface utilisateur, couvrir davantage de scénarios par des tests et apporter des perfectionnements supplémentaires, au lieu d’y renoncer parce que le nombre d’heures de développement nécessaires dépasserait le budget.
Le LLM accélère considérablement la mise en œuvre, mais la qualité dépend toujours du développeur qui le guide. Les développeurs doivent toujours comprendre à quoi doit ressembler une architecture Salesforce adaptée, quels modèles de conception utiliser et quels compromis ils font.
Je n’écris plus vraiment le code moi-même, mais je ne me contente pas non plus d’accepter ce qu’un agent IA génère. J’assume l’entière responsabilité de ce qu’il produit.
Ma revue ne consiste pas seulement à lire le code ligne par ligne. Je définis d’abord l’architecture : ce qu’elle doit être, le framework à utiliser et l’approche à suivre. Ensuite, j’examine le code généré pour repérer les erreurs d’architecture, les complications inutiles, les duplications, les problèmes de passage à l’échelle et ce qui n’a tout simplement pas de sens.
L’essentiel n’est pas de revoir chaque ligne manuellement, mais de savoir quelle architecture on attend avant de commencer la mise en œuvre.
Par exemple, si j’ai un calcul de cumul qui récapitule le nombre total d’heures consacrées à un projet ou à un ticket, éventuellement regroupées par personne, je dois réfléchir à la récursivité. Si je l’intègre à une logique de mise à jour de champs, ce calcul peut déclencher des mises à jour récursives. Cela peut entraîner des exceptions SOQL 101 ou des exceptions liées aux limites CPU particulièrement problématiques dans Salesforce.
Un agent IA peut générer quelque chose qui fonctionne sur dix enregistrements. Cela ne signifie pas que le résultat fonctionnera correctement sur de gros volumes de données. Mais comme je comprends ce qu’il faut faire, je peux guider l’agent IA.
Nous pouvons utiliser des frameworks de déclencheurs et transmettre des indicateurs. Dans certains cas, lorsque nous effectuons des calculs de cumul, nous n’avons pas besoin de réexécuter les déclencheurs. Nous pouvons ainsi construire une infrastructure facile à maintenir. C’est là que les connaissances en ingénierie restent importantes.
Une fois la structure en place, les mises à jour successives deviennent beaucoup plus faciles. Les corrections de bugs, les nouvelles fonctionnalités et la refactorisation deviennent plus faciles, et, dans de nombreux cas, le travail peut être délégué à un consultant ou à un administrateur.
En combinant l’IA et les compétences des développeurs, nous pouvons obtenir des gains de productivité significatifs avec Apex et Lightning Web Components (LWC).
Avec LWC, par exemple, OpenAI Codex peut créer des applications impressionnantes dans Salesforce. Pour certains projets, je ne souhaite pas intégrer l’ensemble du travail, des tickets ou des relevés de temps aux données Salesforce. Je peux alors créer des vues de liste flexibles liées aux enregistrements, qui tiennent compte de l’absence de données dans Salesforce et récupèrent les informations via une API.
L’IA est également utile pour de petits détails d’interface, comme l’ajout d’un indicateur de chargement dans un bouton. Je sais que CSS et HTML sont mes points faibles ; je n’aime pas travailler sur les fonctionnalités d’interface et les animations. Codex est parfaitement capable de s’en charger pendant que je me concentre sur le résultat visuel et que je décris les changements souhaités.
Cela ne nous donne toujours pas de réponse unique et claire quant à l’outil qui devrait être le principal outil d’automatisation dans Salesforce. À mon avis, Apex peut être utilisé pour construire la logique centrale.
Par logique centrale, j’entends la logique qui constitue l’ossature du fonctionnement de l’entreprise et couvre les grands processus métier de l’implémentation Salesforce. Il peut s’agir d’actions à la disposition des agents, comme des actions invocables pour les flux. Il peut s’agir d’intégrations écrites en Apex. Il peut aussi s’agir d’opérations sur les données.
Par exemple, après avoir converti un prospect en compte, je pourrais vouloir rechercher des entreprises aux noms similaires, identifier les contacts associés et les convertir également. Ou je pourrais vouloir une meilleure façon d’exécuter des tâches planifiées. Ce sont des opérations centrales qui peuvent prendre en charge des processus métier entiers.
Par intégrations, j’entends des intégrations directes par API depuis Salesforce lorsqu’aucun connecteur n’est disponible et qu’aucun autre outil d’intégration, comme MuleSoft, Talend ou Jitterbit, n’est déjà en place. Ce type de logique peut tout à fait être implémenté en Apex.
J’utiliserais davantage Flow pour l’orchestration et les modifications à apporter avec souplesse : quelque chose qui change relativement souvent, ou dont vous n’êtes pas certain d’avoir toujours besoin. Par exemple, vous pouvez vouloir envoyer un e-mail lorsqu’un prospect atteint une étape, lancer une campagne promotionnelle temporaire ou proposer aux agents un processus guidé par une interface utilisateur. C’est là que Flow est vraiment performant.
Flow et Apex fonctionnent aussi très bien ensemble. Vous pouvez placer la logique centrale dans Apex, utiliser des flux avant et après enregistrement pour modifier ou orchestrer le comportement, et rendre Apex accessible par des actions invocables. Je ne vois pas cela comme une opposition stricte entre Flow et Apex. Ils peuvent très bien se compléter.
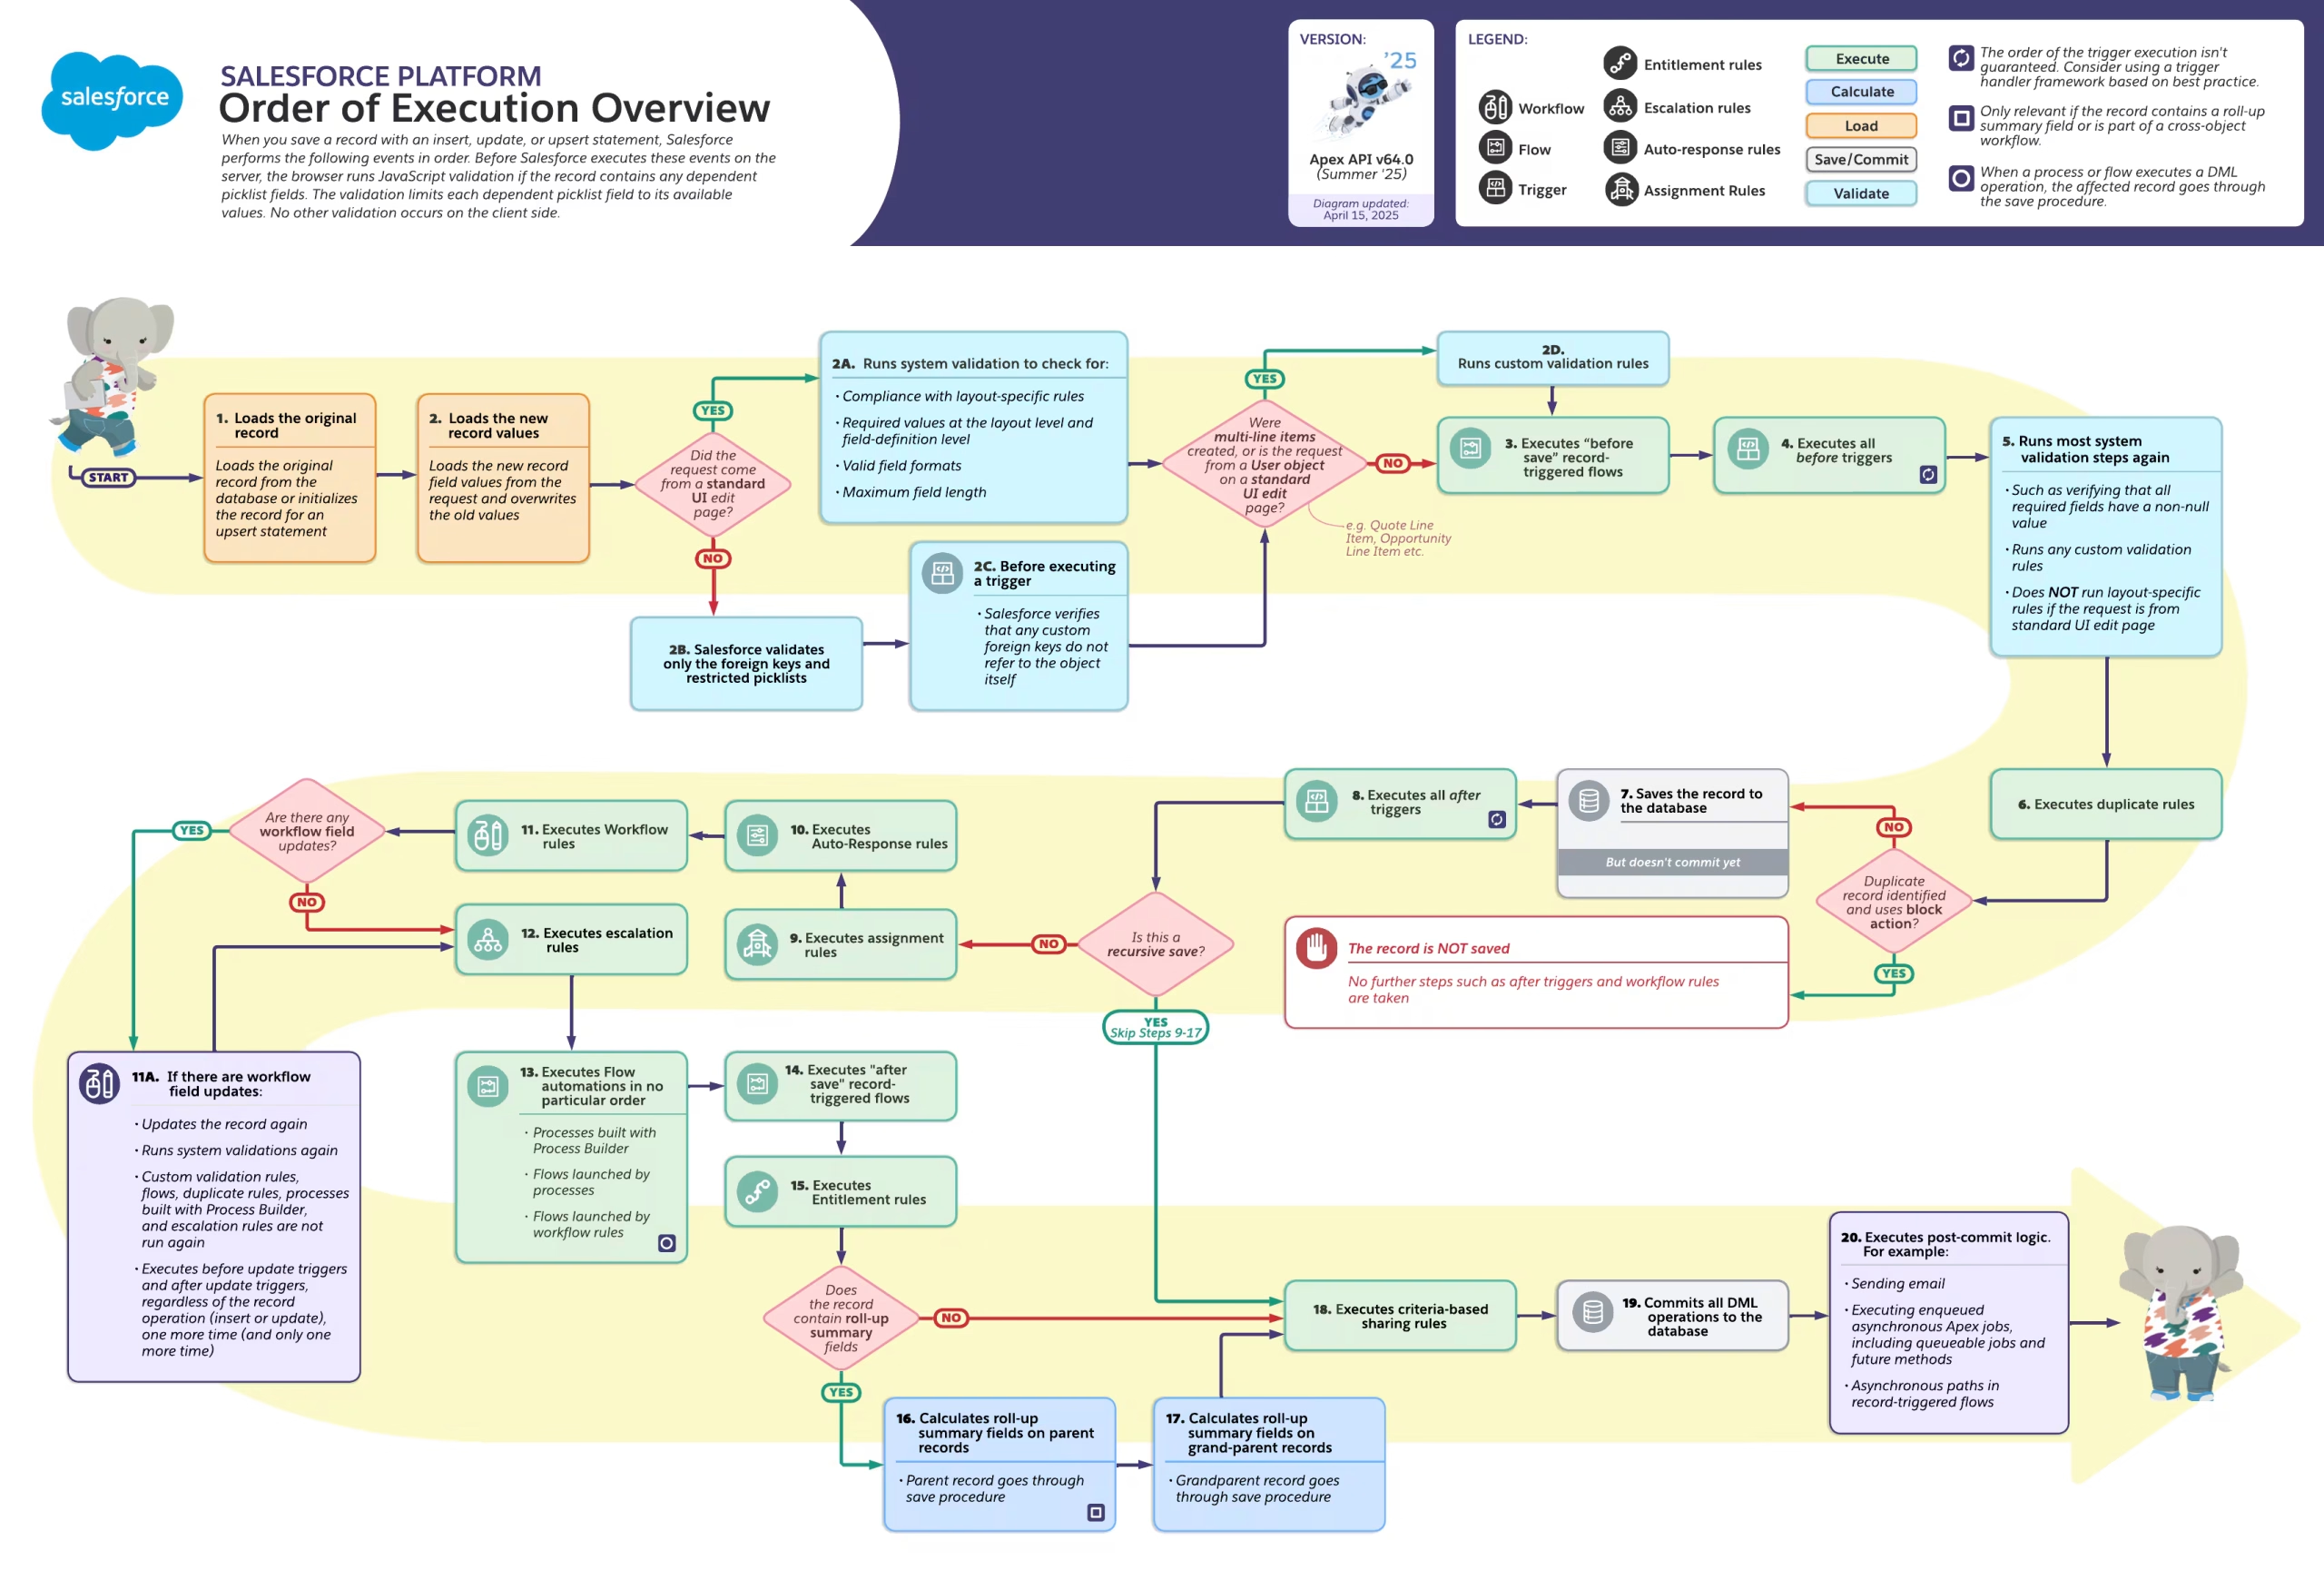
L’ordre d’exécution de Salesforce montre comment les flux, les déclencheurs, la validation, les cumuls, les opérations de base de données et les traitements après validation de la transaction participent au même cycle de vie des enregistrements.
La gestion des modifications est un autre sujet important. Elle ne concerne pas seulement Apex, mais l’ensemble de la couche de métadonnées Salesforce. Flow fait lui aussi partie des métadonnées Salesforce. Il doit être considéré comme du code, même lorsqu’il est représenté sous forme de diagramme visuel.
La priorité doit être de disposer d’un environnement sûr pour développer, d’un autre environnement pour tester, puis de la production. La production est comme un Saint Graal : vous l’observez et y travaillez, mais vous n’y faites pas d’expérimentations.
Je vois de nombreuses implémentations réalisées directement en production. C’est un problème plus important que le choix entre Flow et Apex.
Dans un monde idéal, vous pouvez utiliser des organisations scratch. Si vous partez de zéro pour votre implémentation, une organisation scratch est un bon point de départ. Vous pouvez utiliser un package géré ou non géré pour les fonctionnalités centrales, le déployer et exécuter un script pour initialiser les données de test. La création de tels scripts d’initialisation est également une tâche facile pour les LLM.
Vous disposez alors d’un environnement d’assurance qualité dans lequel vous pouvez tester la logique avec des données fictives, distinctes de celles de production. Vous n’avez donc pas à craindre d’envoyer une fausse facture ou un e-mail à de vrais clients au sujet d’une remise qui n’existe pas.
Une fois les tests effectués, vous déployez le même code source ou le même package en production. Les outils peuvent varier : organisations scratch, sandbox Salesforce, packages ou CI/CD. C’est secondaire. L’essentiel est que le développement, les tests et la production restent séparés.
Ma position n’est pas que tout le monde devrait cesser d’utiliser Flow pour passer à Apex. Je ne pense pas qu’Apex devrait devenir le choix par défaut partout.
Ce que je dis, c’est qu’Apex présente bien plus d’avantages qu’il y a six ans. Les arguments contre Apex, à savoir le coût, la complexité et la maintenance, ont moins de poids aujourd’hui, car les outils de programmation assistée par l’IA ont changé l’équation économique du développement.
En parallèle, Flow n’a jamais été aussi simple qu’on le laissait entendre. Utiliser Flow reste de la programmation. Cela exige toujours une réflexion algorithmique, de l’architecture, des tests, une gestion du changement et des compétences en génie logiciel.
Je ne pense plus que « utilisez Flow sauf si vous avez absolument besoin d’Apex » soit une bonne approche par défaut. Je ne pense pas non plus qu’« utilisez Apex partout » soit une bonne réponse. Chaque implémentation est un cas unique.
Vous devez tenir compte de ce que vous construisez. Êtes-vous une petite ou une grande entreprise ? Quel degré de personnalisation vous faut-il ? Dans quelle mesure la logique est-elle stable ? Qui en assurera la maintenance ? De quelles compétences en ingénierie disposez-vous ? À quelle fréquence la logique changera-t-elle ? Quel volume de données avez-vous ? Ensuite, vous décidez.
Personnellement, je privilégie plutôt Apex pour une logique centrale stable et réutilisable. Pour l’orchestration, les processus guidés par une interface utilisateur, les notifications et les modifications qui demandent de la souplesse, je privilégie plutôt Flow.
Lorsqu’un flux commence à devenir un gros algorithme avec des boucles, des requêtes, des regroupements, des correspondances entre données et une logique compliquée, je prendrais au moins le temps de me demander s’il doit toujours rester un flux.
Ce n’est pas une règle universelle. C’est un sujet de discussion, et cette discussion est aujourd’hui beaucoup plus intéressante que la simple affirmation selon laquelle Flow est facile et Apex difficile.
Critère | Flow | Apex | Mon avis et les idées reçues |
|---|---|---|---|
Test de simplicité | Visuel et accessible | Nécessite de savoir lire du code | Flow semble plus simple parce qu’il est visuel, mais sa logique sous-jacente peut être tout aussi complexe. |
Usages les plus adaptés | Orchestration, interface utilisateur guidée, notifications, logique qui change fréquemment | Logique centrale stable, intégrations, traitement des données, services réutilisables | Envisagez Apex aux côtés de Flow dès le départ, et pas seulement après avoir épuisé les options déclaratives. |
Maintenabilité | Bonne tant que les flux restent petits et clairs | Bonne lorsque l’architecture et la structure sont claires | La maintenabilité dépend davantage de la rigueur d’ingénierie que du choix entre représentation visuelle et code. |
Compétences en ingénierie | Facile à prendre en main au départ | Prise en main initiale plus exigeante | Le low-code ne supprime pas la nécessité d’un raisonnement d’ingénierie méthodique. |
Tests | Les tests existent, mais il est plus facile de les omettre | Les tests unitaires font partie du processus habituel de développement Apex | Flow doit être traité comme du code, avec des tests capables de détecter les défaillances avant le déploiement. |
Traitements complexes | Les requêtes, les boucles, les correspondances entre données et les regroupements peuvent devenir difficiles à gérer | Généralement plus faciles à exprimer directement | Ce n’est pas parce que Flow peut faire quelque chose qu’il constitue la meilleure façon d’exprimer l’algorithme. |
Revue de code | Facile à comprendre visuellement, plus difficile à examiner sous forme de XML | Facile à examiner dans un système de gestion de versions | Un Flow peut devenir plus difficile à examiner qu’Apex lorsqu’on passe à Git et aux processus de développement habituels. |
Développement assisté par IA | D’après mon expérience, les LLM sont moins fiables avec les métadonnées Flow | D’après mon expérience, les LLM sont très performants avec Apex | L’IA a largement réduit le désavantage historique d’Apex en matière de développement et de maintenance. |
Gouvernance | Peut devenir désordonné avec des automatisations en double et inactives | Peut devenir désordonné avec une architecture mal conçue | Le problème n’est pas l’outil. C’est la manière dont vous l’utilisez. |
Ensemble | Une couche d’orchestration solide | Un socle réutilisable solide | Flow et Apex peuvent se compléter plutôt que d’être considérés comme des solutions strictement alternatives. |
Le regard d’un praticien sur la place de Flow et d’Apex dans les mises en œuvre modernes de Salesforce.