 English
 Suomi
 Français
 Polski
Möchten Sie Routineaufgaben automatisieren?
Kontaktieren Sie uns noch heute, um das Kundenerlebnis und die Produktivität zu verbessern.
Kürzlich habe ich darüber nachgedacht, warum Flow bei Implementierungen in Salesforce nach wie vor fast immer als erste Wahl gilt.
Flow ist sofort einsatzbereit, visuell und klar strukturiert. Die Farben sehen schön aus. Es wird als Lösung positioniert, die Administratoren selbst pflegen können. Apex hingegen gilt häufig als äußerst komplex, stark individualisiert, teuer in der Entwicklung und aufwendig in der Wartung.
In vielen Artikeln, die Flow und Apex vergleichen, wird Flow von vornherein als die bessere Option dargestellt. Dabei werden immer dieselben Vorteile genannt: Flow sei einfacher, leichter zu warten, erfordere weniger technische Kenntnisse und sei generell der empfohlene Weg.
Ich habe begonnen, darüber nachzudenken, ob diese Position heute noch Bestand hat. Mit KI-gestützter Programmierung und Vibe-Coding-Tools sind viele der bisherigen Argumente gegen Apex nicht mehr so überzeugend wie früher. Gleichzeitig wird Flow meiner Meinung nach oft als viel einfacher dargestellt, als es tatsächlich ist.
Mein Kerngedanke ist einfach: Apex ist nicht so schwierig, und Flows sind nicht so einfach. Ihre Komplexität liegt deutlich näher beieinander, als häufig angenommen wird.
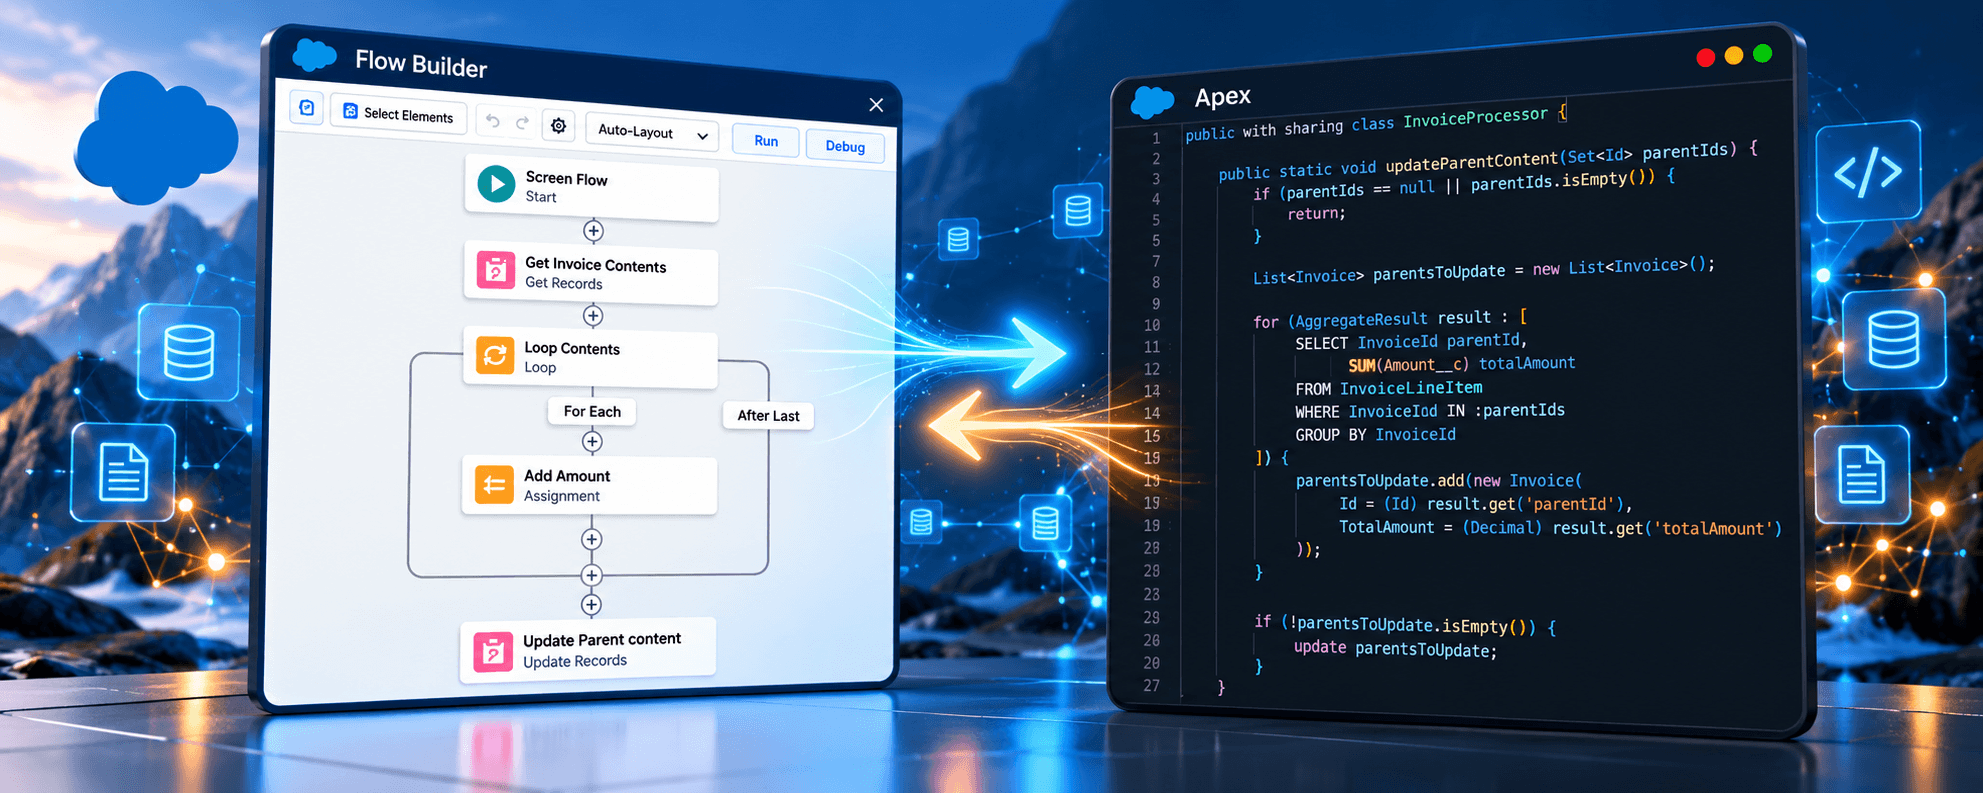
Beginnen wir mit Flows. Sie enthalten viele Strukturen, die es auch in Apex gibt: Iterationen, Abfragen, Aktionen, Bedingungen, Zuweisungen und so weiter.
Grundsätzlich müssen Sie wissen, wie man eine Anwendung und einen Algorithmus entwickelt. Ein Flow ist ein Algorithmus, genau wie Code.
Im Hintergrund ist Flow eine XML-Darstellung dieses Algorithmus, während Apex eine Programmiersprache ist, die ebenfalls einen Algorithmus abbildet. In beiden Fällen wird der Algorithmus für die Maschine verständlich, die ihn ausführt.
Ist die Flow-Logik einfach? Nicht ganz. Die Flow-Logik wird visuell dargestellt.
Diese visuelle Darstellung vermittelt den Eindruck, dass Flow einfacher ist als Apex. Meiner Meinung nach kann diese Einfachheit täuschen.
Mit Flow lassen sich viele derselben Aufgaben lösen wie mit Apex, und über aufrufbare Aktionen lassen sich Flow und Apex kombinieren. In vielen Fällen erfüllen sie denselben Zweck und werden über ähnliche Einstiegspunkte ausgeführt, darunter Datensatzaktualisierungen, Zeitpläne und Benutzeraktionen innerhalb von Salesforce.
Aus Komplexitätssicht können Flows einfacher aussehen, da es sich um visuelle Diagramme handelt, während Apex etwas ist, das man lesen muss. Aber Flow sollte mit derselben Sorgfalt behandelt werden wie Apex. Eine Einführung finden Sie in unserer Salesforce Flow Builder-Übersicht.
Wenn wir sagen, dass Admin-Teams für die Pflege von Automatisierungen ausreichen, kann das stimmen – allerdings nur unter einer wichtigen Voraussetzung: Wer Flow pflegt, sollte wissen, wie man Algorithmen entwickelt.
Sie brauchen eine Denkweise, mit der sie schrittweise Algorithmen entwickeln, Ausweichlösungen für Fehlerfälle berücksichtigen, mögliche Probleme vorhersehen und künftige Anforderungen mitdenken können. Außerdem brauchen sie eine Möglichkeit, diese Funktionalität automatisiert zu testen.
Von allen, die solche Automatisierungen implementieren, würde ich systematisches Denken und ein Verständnis dafür erwarten, wie man Algorithmen, Systeme und Anwendungen entwickelt.
Sie sollten beurteilen können, welche Eingaben für den Algorithmus ungültig sind, welche Ergebnisse zu erwarten sind und welche Fehler sich behandeln lassen und welche nicht.
Low-Code macht eine ingenieurmäßige Denkweise in der Softwareentwicklung nicht überflüssig. KI-generierter Code tut das ebenso wenig.
Flow ist perfekt, wenn die Automatisierung einfach ist. Wenn die Anforderung lautet: „Wenn meine Opportunity abgeschlossen und gewonnen ist, senden Sie eine E-Mail-Benachrichtigung“, dann können Sie sie in Flow perfekt verwalten.
Wenn Sie einen über die Benutzeroberfläche geführten Prozess für Ihre Mitarbeitenden möchten, ist Flow ebenfalls bestens geeignet. Wenn Sie heute eine Werbe-E-Mail versenden, dafür einen Flow für eine Kampagne erstellen und ihn in drei Monaten wieder deaktivieren oder ändern möchten, ist Flow eine gute Wahl. Genau hier liegen die Stärken von Flow.
Wenn es jedoch um komplexere Aufgaben geht – beispielsweise alle Leads zu finden, deren Feld „Company“ dem Namen des Accounts ähnelt, in den Sie gerade einen Lead konvertiert haben, und anschließend auch diese Leads zu konvertieren –, sieht die Sache anders aus.
Meine persönliche Faustregel lautet: Sobald ein Flow mehr als ungefähr zehn Elemente enthält, schaue ich bereits genauer hin. Wenn der Flow Iterationen und Abfragen kombiniert oder Datensätze abfragen, sammeln, zuordnen, gruppieren oder analysieren muss, wird er meiner Meinung nach bereits komplex. Das ist keine offizielle Best Practice von Salesforce. Es ist lediglich meine persönliche Faustregel.
An diesem Punkt kann es, insbesondere mit KI-generiertem Code, wesentlich einfacher sein, dasselbe in Apex umzusetzen. Ich würde Logik nicht in Flow unterbringen, wenn ich einen Datensatzwert einem anderen zuordnen, Datensätze analysieren oder gruppieren, Massendaten verarbeiten oder transaktionsintensive Logik umsetzen muss.
Das liegt nicht daran, dass Flow dazu nicht in der Lage wäre. Das ist es durchaus. Doch nur weil sich etwas in Flow umsetzen lässt, ist Flow nicht zwangsläufig die beste Möglichkeit, den Algorithmus auszudrücken. Ein sehr großer Flow lässt sich unter Umständen durch wenig Apex-Code ersetzen.
Wenn ich sage, dass Superuser mit Flow kläglich scheitern können, meine ich nicht, dass Flow schlecht ist. Es liegt nicht am Tool, sondern daran, wie Sie es verwenden. Das Problem liegt zwischen der Tastatur und dem Stuhl.
Es gibt Implementierungen, in deren Org sich zahlreiche aktive und deaktivierte Flows, ungenutzte Felder, doppelte Felder, doppelte Flows und doppelte Logik angesammelt haben. Das System funktioniert möglicherweise noch, doch jeder neue Fehler und jedes neue Problem erhöht in einer solchen Konstellation die Wartungskosten.
Anders als bei Apex sind Unit-Tests für Flows nicht verpflichtend. Ja, man kann Tests erstellen, die die Automatisierungslogik von Flow abdecken, doch vorgeschrieben ist das nicht – und was nicht vorgeschrieben ist, wird oft ausgelassen.
Es geht nicht darum, dass Flow nicht getestet werden könnte. Es geht darum, dass Flow den irreführenden Eindruck erwecken kann, aufgrund seiner visuellen Darstellung gewissermaßen kein Code zu sein und deshalb nicht dieselbe Disziplin zu erfordern.
Flow sollte wie Code behandelt werden. Namenskonventionen, Bereinigung, Versionsverwaltung, Tests, Peer-Reviews und ein Bereitstellungsprozess sollten dazugehören.
Dies unterscheidet sich von Apex, wo Tests für die Produktionsbereitstellung obligatorisch sind und der erforderliche Schwellenwert für die Codeabdeckung erreicht werden muss. Ein Flow kann ohne automatisierte Tests bereitgestellt werden. Der Punkt ist nicht, dass Flow nicht getestet werden kann; der Punkt ist, dass Tests leichter übersprungen werden können, wenn die Plattform dies nicht erfordert.
Bei einem Peer-Review kann Flow tatsächlich schwieriger zu prüfen sein als Apex. Wenn ich Apex-Code in GitHub öffne, kann selbst jemand, der in Java programmiert, Duplikate, riesige Methoden, schlechte Architektur, komplizierte Bedingungen und Schleifen oder unklare Zuständigkeiten erkennen.
Bei Flow-XML ist das viel schwieriger. Selbst Salesforce-Entwickler können einen Flow in GitHub nicht angemessen prüfen, indem sie nur das XML betrachten; sie müssen den Flow in der visuellen Ansicht öffnen. Obwohl Flow innerhalb von Salesforce einfach aussieht, kann es aus Sicht der Versionsverwaltung und des Code-Reviews also weniger transparent sein.
Ich möchte damit nicht sagen, dass Apex jetzt der Standard für die Entwicklung sämtlicher Salesforce-Automatisierungen sein sollte. Ich gehe der Überlegung nach, dass Apex weit mehr Vorteile bietet als etwa vor sechs Jahren.
Viele der früheren Argumente gegen Apex – Komplexität sowie Entwicklungs- und Wartungskosten – wiegen heute weniger schwer. Der Hauptgrund dafür sind KI-Tools für die Codeentwicklung.
Apex ähnelt Java und C#. Wer C# bevorzugt, wird viele Ähnlichkeiten mit C# erkennen, und wer Java bevorzugt, wird sich ebenfalls schnell zurechtfinden. Eine Programmiersprache, die solchen verbreiteten Sprachen ähnelt, ist hier von Vorteil.
Es gibt sehr viel Code in Java, C#, JavaScript, HTML und zahlreichen anderen Technologien. Moderne große Sprachmodelle können mit diesen Sprachen sehr gut umgehen und meiner Erfahrung nach auch mit Apex und Lightning Web Components.
Ich vermute, dass dies auch ein Grund dafür ist, warum LLMs mit Flow-Metadaten deutlich schlechter zurechtkommen: Für Salesforce Flow XML gibt es weniger Trainingsdaten, und in öffentlichen GitHub-Repositorys sind nur wenige Flows zu finden. Das ist meine Vermutung, nichts, was ich beweisen kann.
Meiner Erfahrung nach sind LLMs wesentlich besser darin, Apex zu generieren, als Flow-Metadaten von Grund auf zu erstellen. Bei Flow habe ich Fehlversuche erlebt, bei denen das Modell die Aufgabe vereinfacht, zahlreiche aufrufbare Aktionen erstellt und dem Flow kaum mehr als die Rolle eines Einstiegspunkts überlässt. Ich habe auch generiertes XML gesehen, das sich nicht korrekt in Salesforce bereitstellen ließ.
Einen vorhandenen Flow zu ändern, ist für ein LLM einfacher, als in einer leeren Org etwas Neues zu erstellen. Aber selbst dann können Fehler entstehen.
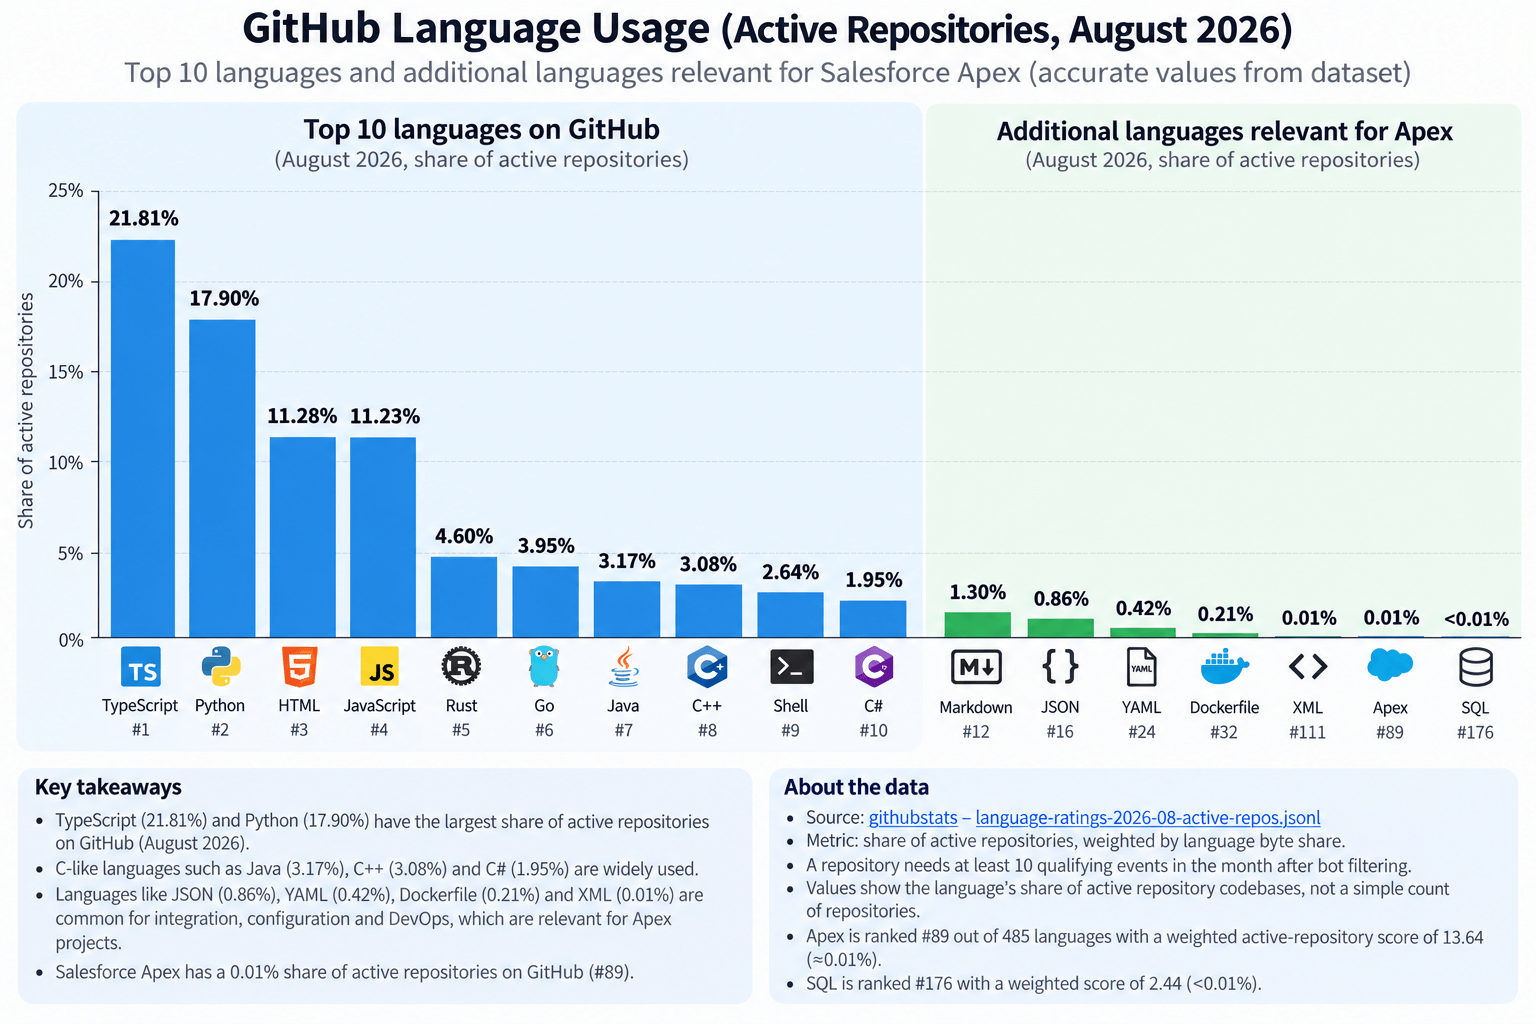
Im Vergleich zu weitverbreiteten Programmiersprachen macht Apex nur einen sehr kleinen Anteil der aktiven öffentlichen GitHub-Repositorys aus. Das verdeutlicht den Unterschied im Umfang des öffentlich sichtbaren Codes, ist für sich genommen aber kein Beleg dafür, dass ein LLM mit Apex besser oder mit Flow-Metadaten schlechter arbeitet.
Mit Tools wie Codex, Claude Code oder OpenCode können Entwickler ein LLM heute direkt mit einem Entwicklungsprojekt oder einer Salesforce-Codebasis verbinden.
Das LLM kann bestimmte Stellen in der Codebasis finden, Probleme und Fehler erkennen, die Logik nachvollziehen und Änderungen deutlich schneller erstellen als ein Entwickler von Hand. Auch die eigentliche Codegenerierung ist sehr schnell, sodass Entwickler wesentlich zügiger entwickeln und iterieren können.
Das macht Fachwissen in der Softwareentwicklung jedoch nicht überflüssig.
Entwickler, die verstehen, wie Salesforce konzipiert werden sollte, können das LLM zu den richtigen Architekturentscheidungen, Implementierungsansätzen und Programmiermustern hinführen. So können sie sauberen, funktionierenden Code erstellen, ohne genauso viel Zeit darauf verwenden zu müssen, alles selbst zu schreiben.
Arbeiten, die früher einen Monat dauern konnten, lassen sich heute manchmal innerhalb mehrerer Tage abschließen.
Der Unterschied liegt nicht nur in der Geschwindigkeit.
Entwickler können mehr Zeit auf die Dinge verwenden, die wirklich zählen: Kernlogik, Architektur, Randfälle, Benutzererfahrung und Wartbarkeit. Sie können die Benutzeroberfläche verbessern, mehr Szenarien durch Tests abdecken und zusätzliche Verfeinerungen vornehmen, statt sie zu streichen, weil die dafür nötigen Entwicklungsstunden den Budgetrahmen sprengen würden.
Das LLM beschleunigt die Implementierung erheblich, doch die Qualität hängt weiterhin von dem Entwickler ab, der es anleitet. Entwickler müssen nach wie vor verstehen, wie die richtige Salesforce-Architektur aussehen sollte, welche Muster einzusetzen sind und welche Kompromisse sie eingehen.
Ich schreibe den Code eigentlich nicht mehr selbst, übernehme aber auch nicht einfach, was ein KI-Agent generiert. Ich trage die volle Verantwortung für seine Ergebnisse.
Bei meiner Codeprüfung gehe ich nicht nur Zeile für Zeile vor. Zuerst lege ich die Architektur fest: wie sie aussehen, welches Framework sie verwenden und welchem Ansatz sie folgen soll. Anschließend prüfe ich den generierten Code auf Architekturfehler, unnötige Komplexität, Duplikate, Skalierungsprobleme und Dinge, die schlicht keinen Sinn ergeben.
Entscheidend ist nicht, jede Zeile manuell zu prüfen. Entscheidend ist, schon vor Beginn der Implementierung zu wissen, welche Architektur man erwartet.
Wenn ich beispielsweise eine Rollup-Berechnung habe, die die insgesamt für ein Projekt oder einen Vorgang aufgewendeten Stunden zusammenfasst, möglicherweise nach Person gruppiert, muss ich an Rekursion denken. Wenn ich sie in die Logik zur Feldaktualisierung einbinde, kann das Rollup rekursive Aktualisierungen auslösen. Das kann innerhalb von Salesforce zu unangenehmen SOQL-101- oder CPU-Limit-Ausnahmen führen.
Ein KI-Agent generiert möglicherweise etwas, das mit zehn Datensätzen funktioniert. Das bedeutet nicht, dass es auch bei großen Datenmengen ordnungsgemäß funktioniert. Da ich aber verstehe, was getan werden sollte, kann ich den KI-Agenten entsprechend anleiten.
Wir können Trigger-Frameworks verwenden und Flags übergeben. In manchen Fällen müssen wir bei der Berechnung von Rollup-Zusammenfassungen die Trigger nicht erneut ausführen. So können wir eine wartbare Infrastruktur aufbauen. Genau hier bleibt Fachwissen in der Softwareentwicklung wichtig.
Sobald die Struktur steht, werden iterative Aktualisierungen deutlich einfacher. Fehlerbehebungen, neue Funktionen und Refactoring fallen leichter, und in vielen Fällen lassen sich Aufgaben an einen Berater oder Administrator delegieren.
Durch die Kombination von KI und Entwicklerkompetenz können wir bei Apex und Lightning Web Components (LWC) erhebliche Produktivitätssteigerungen erzielen.
Mit LWC kann OpenAI Codex beispielsweise beeindruckende Anwendungen innerhalb von Salesforce erstellen. Bei einigen Projekten möchte ich nicht alle Aufgaben, Vorgänge oder Arbeitszeitprotokolle in Salesforce-Daten übernehmen. Stattdessen kann ich flexible, datensatzbezogene Listenansichten erstellen, die verstehen, dass keine Salesforce-Daten vorhanden sind, und die Informationen von einer API abrufen.
KI ist auch bei kleinen Details der Benutzeroberfläche hilfreich, etwa wenn ein Ladeindikator in einer Schaltfläche platziert werden soll. Ich weiß, dass CSS und HTML meine Schwachstellen sind; ich arbeite mich nicht gern durch Oberflächenfunktionen und Animationen. Codex kann diese Arbeit problemlos übernehmen, während ich mich auf das konzentriere, was ich sehe, und beschreibe, was geändert werden soll.
Damit haben wir immer noch keine eindeutige Antwort darauf, welches Tool das primäre Automatisierungswerkzeug innerhalb von Salesforce sein sollte. Meiner Meinung nach lässt sich Apex für die Entwicklung der Kernlogik einsetzen.
Mit Kernlogik meine ich die Logik, die das Rückgrat der Arbeitsweise einer Organisation bildet und die wesentlichen Geschäftsprozesse in der Salesforce-Implementierung abdeckt. Das können Aktionen sein, die Mitarbeitenden zur Verfügung stehen, etwa aufrufbare Aktionen für Flows. Es können in Apex geschriebene Integrationen sein. Oder Operationen zur Datenverarbeitung.
Wenn ich beispielsweise einen Lead in einen Account konvertiert habe, möchte ich möglicherweise Unternehmen mit ähnlichen Namen finden, zugehörige Kontakte identifizieren und diese ebenfalls konvertieren. Oder ich suche nach einer besseren Möglichkeit, geplante Jobs auszuführen. Solche Kernoperationen können ganze Geschäftsprozesse unterstützen.
Bei Integrationen meine ich direkte API-Integrationen von Salesforce, wenn kein Connector verfügbar ist und kein anderes Integrationstool – wie MuleSoft, Talend oder Jitterbit – bereits vorhanden ist. Diese Art von Logik lässt sich sehr gut in Apex umsetzen.
Flow würde ich eher für die Orchestrierung und flexible Anpassungen einsetzen: für etwas, das sich relativ häufig ändert, oder für etwas, bei dem noch nicht sicher ist, ob es dauerhaft gebraucht wird. Vielleicht möchten Sie beispielsweise eine E-Mail versenden, wenn ein Interessent eine bestimmte Phase erreicht, eine zeitlich begrenzte Werbekampagne durchführen oder Mitarbeitenden einen über die Benutzeroberfläche geführten Prozess bereitstellen. Hier ist Flow wirklich stark.
Flow und Apex passen auch sehr gut zusammen. Sie können Kernlogik in Apex platzieren, Before-Save- und After-Save-Flows verwenden, um das Verhalten zu ändern oder zu orchestrieren, und Apex über aufrufbare Aktionen verfügbar machen. Ich betrachte dies nicht als Flow versus Apex im engeren Sinne. Sie können sich sehr gut ergänzen.
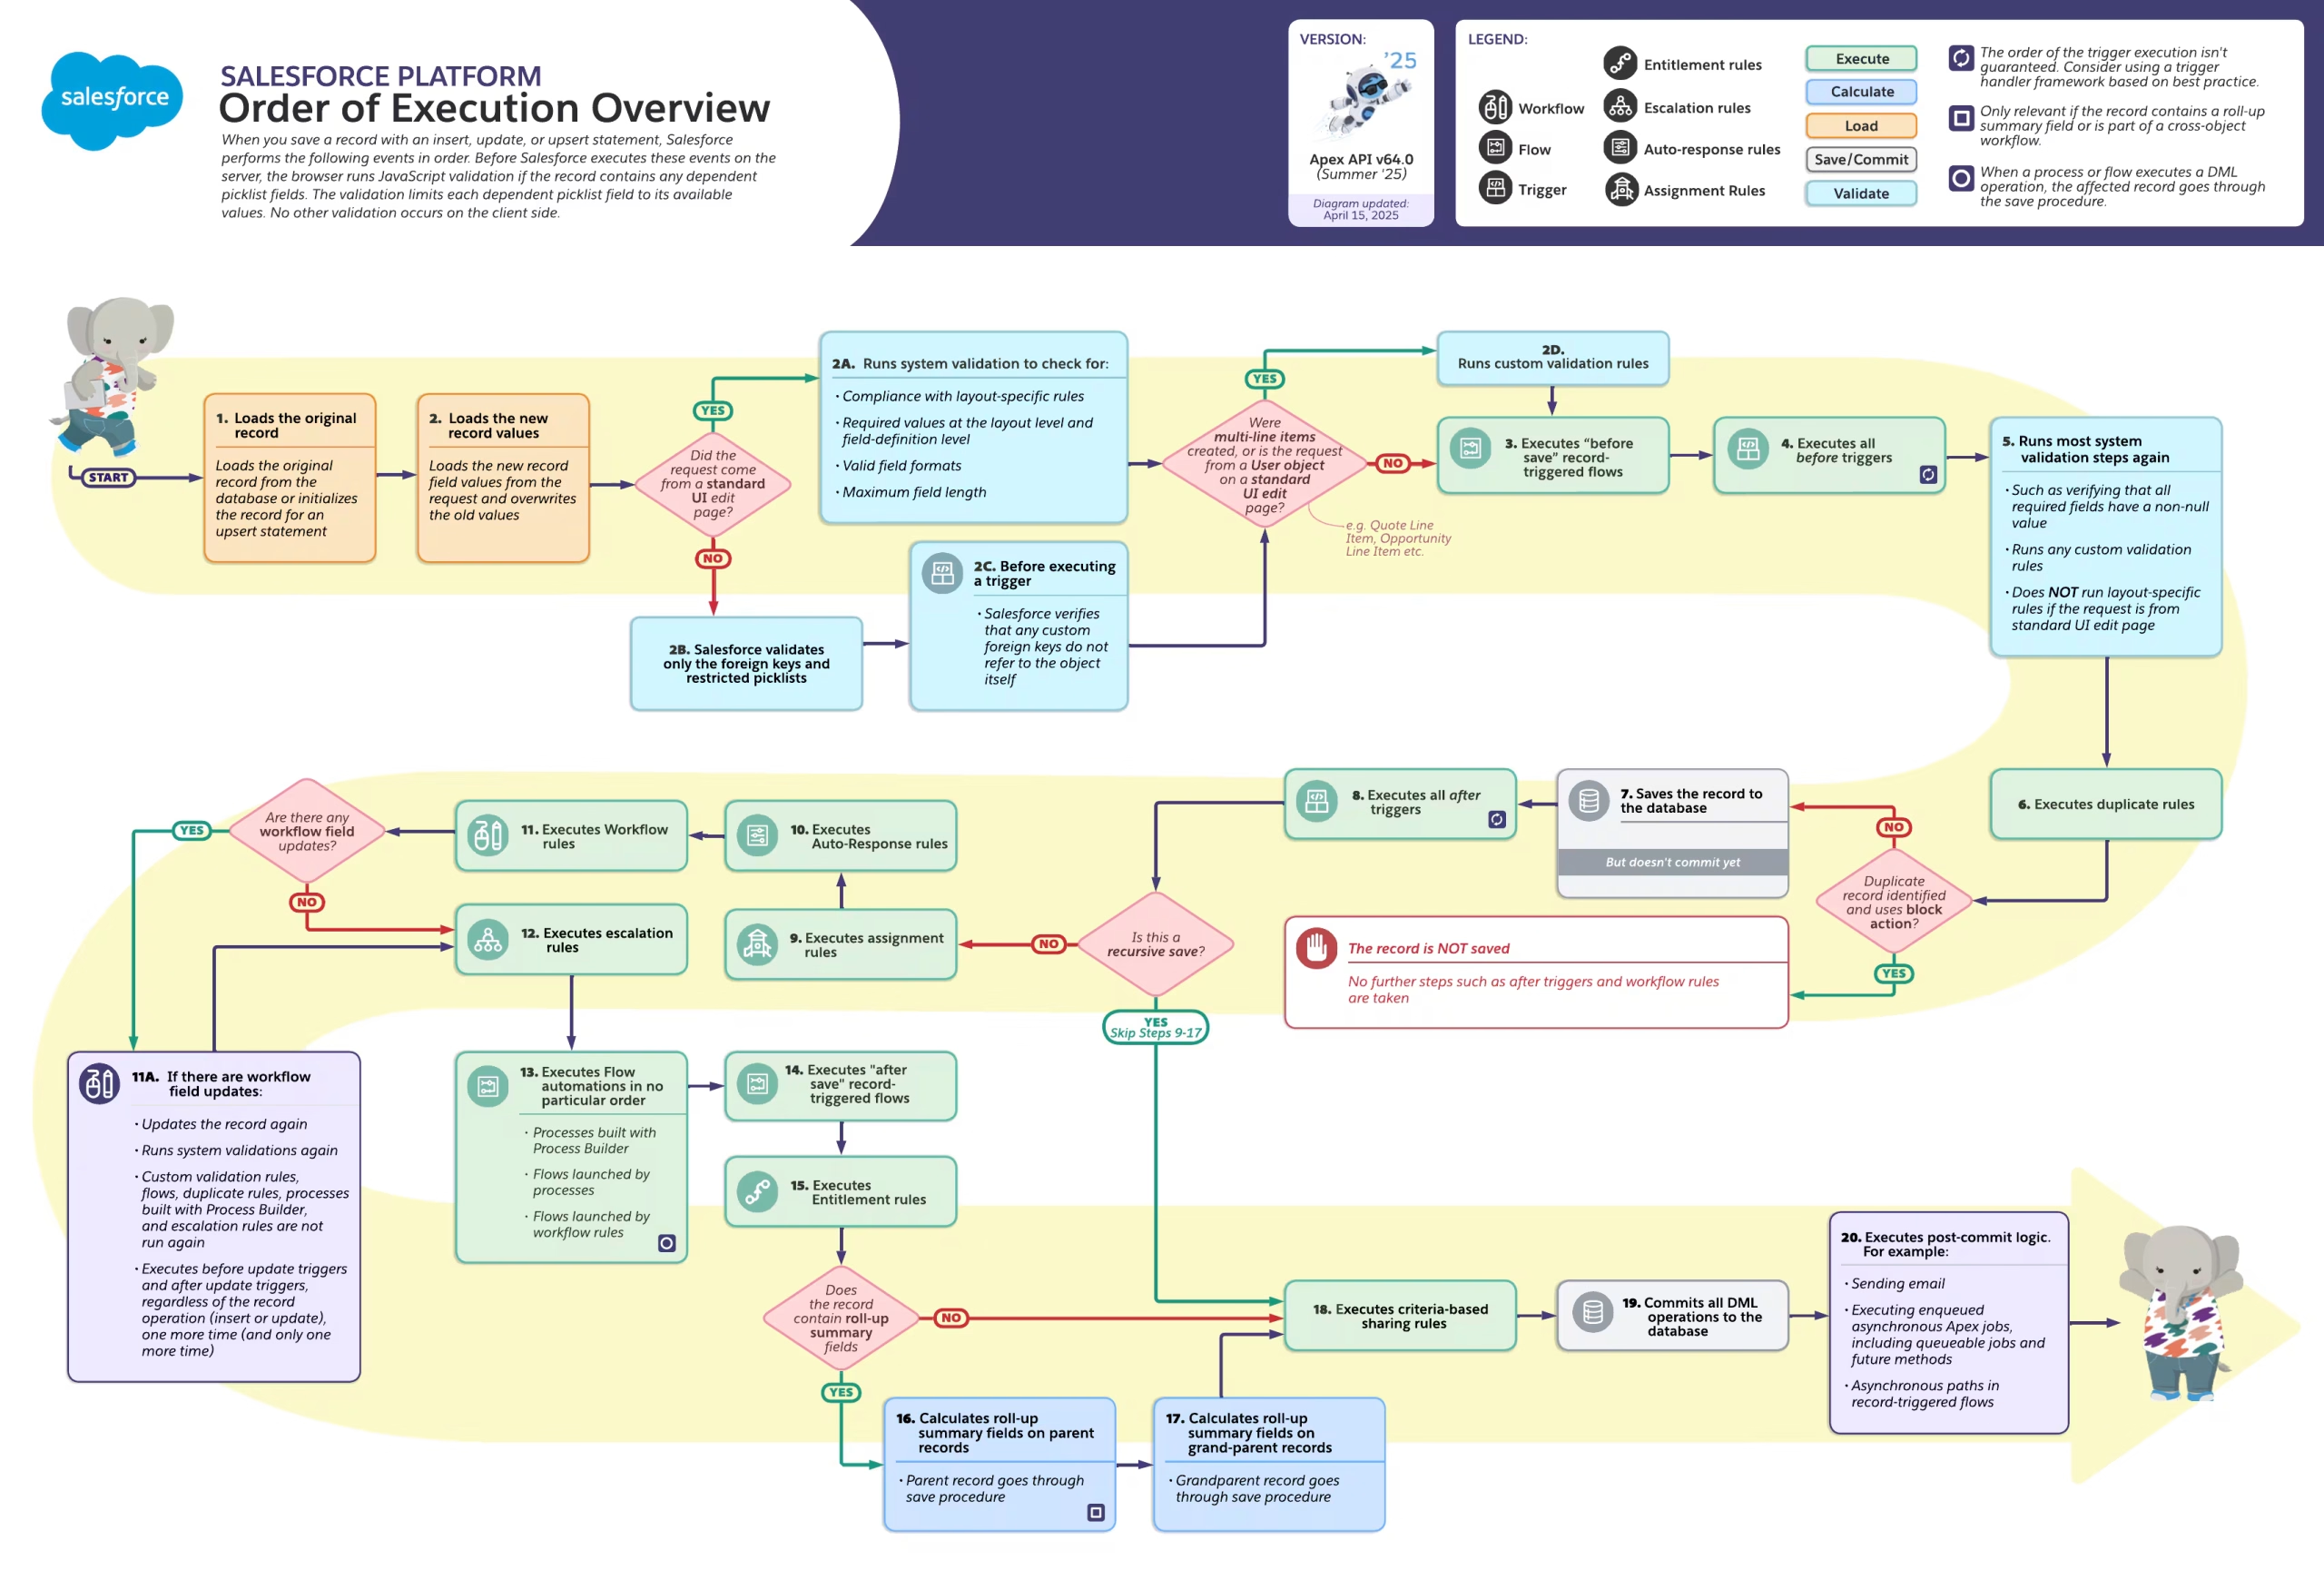
Die Ausführungsreihenfolge von Salesforce zeigt, wie Flows, Trigger, Validierungen, Rollups, Datenbankvorgänge und Post-Commit-Arbeiten am selben Datensatzlebenszyklus beteiligt sind.
Ein weiteres wichtiges Thema ist das Änderungsmanagement. Das betrifft nicht nur Apex, sondern die gesamte Salesforce-Metadatenebene. Auch Flow besteht aus Salesforce-Metadaten. Es sollte als Code behandelt werden, selbst wenn es als visuelles Diagramm dargestellt wird.
Entscheidend sind eine sichere Entwicklungsumgebung, eine separate Testumgebung und anschließend die Produktionsumgebung. Die Produktion ist wie ein heiliger Gral: Man beobachtet sie und arbeitet darin, experimentiert dort aber nicht.
Ich sehe viele Implementierungen, die direkt in der Produktionsumgebung entwickelt werden. Das ist ein größeres Problem als die Frage, ob jemand Flow oder Apex verwendet hat.
Im Idealfall können Sie Scratch Orgs verwenden. Bei einer Neuimplementierung ist eine Scratch Org ein guter Ausgangspunkt. Für die Kernfunktionalität können Sie ein verwaltetes oder nicht verwaltetes Paket einsetzen, es bereitstellen und anschließend ein Skript zur Initialisierung der Testdaten ausführen. Solche Initialisierungsskripte zu erstellen, ist auch für LLMs eine einfache Aufgabe.
Anschließend steht Ihnen eine Qualitätssicherungsumgebung zur Verfügung, in der Sie die Logik mit fiktiven Daten statt Produktionsdaten testen können. So müssen Sie nicht befürchten, versehentlich eine fiktive Rechnung oder eine E-Mail über einen nicht existierenden Rabatt an echte Kunden zu senden.
Nach dem Test stellen Sie dieselbe Quelle oder dasselbe Paket für die Produktion bereit. Die Tools können unterschiedlich sein: Scratch Orgs, Salesforce-Sandboxes, Pakete oder CI/CD. Das ist zweitrangig. Der wichtige Punkt ist, dass Entwicklung, Test und Produktion getrennt bleiben.
Meine Position ist nicht, dass alle aufhören sollten, Flow zu verwenden, und zu Apex wechseln sollten. Ich halte es nicht für sinnvoll, Apex überall zum Standard zu machen.
Was ich sage, ist, dass Apex weit mehr Vorteile bietet als vor sechs Jahren. Die Argumente gegen Apex – Kosten, Komplexität und Wartung – wiegen heute weniger schwer, weil KI-Programmierwerkzeuge die Wirtschaftlichkeit der Entwicklung verändert haben.
Gleichzeitig war Flow nie so einfach, wie es häufig dargestellt wurde. Auch die Arbeit mit Flow ist Programmierung. Sie erfordert weiterhin algorithmisches Denken, Architektur, Tests, Änderungsmanagement und Softwareentwicklung.
Ich halte „Verwenden Sie Flow, sofern Sie Apex nicht unbedingt benötigen“ nicht mehr für eine gute Standardempfehlung. „Verwenden Sie überall Apex“ halte ich ebenfalls nicht für eine gute Antwort. Jede Implementierung hat ihre eigenen Voraussetzungen.
Sie müssen berücksichtigen, was Sie entwickeln. Sind Sie ein kleines oder ein großes Unternehmen? Wie viele individuelle Anpassungen benötigen Sie? Wie stabil ist die Logik? Wer wird sie warten? Über welche Kompetenzen in der Softwareentwicklung verfügen Sie? Wie häufig wird sich die Logik ändern? Mit welchen Datenmengen arbeiten Sie? Danach treffen Sie Ihre Entscheidung.
Für mich persönlich gehört stabile, wiederverwendbare Kernlogik eher in Apex. Orchestrierung, über die Benutzeroberfläche geführte Prozesse, Benachrichtigungen und flexible Anpassungen gehören eher in Flow.
Wenn ein Flow zu einem umfangreichen Algorithmus mit Schleifen, Abfragen, Gruppierungen, Zuordnungen und komplizierter Logik wird, würde ich zumindest innehalten und noch einmal überlegen, ob er weiterhin ein Flow sein sollte.
Das ist keine allgemeingültige Regel. Es ist eine Diskussion – und diese Diskussion ist heute wesentlich interessanter, als einfach zu sagen, Flow sei leicht und Apex schwer.
Bereich | Flow | Apex | Meine Einschätzung / Mythen im Faktencheck |
|---|---|---|---|
Einfachheitstest | Visuell und leicht zugänglich | Erfordert das Lesen von Code | Flow wirkt durch seine visuelle Darstellung einfacher, doch die zugrunde liegende Logik kann genauso komplex sein. |
Am besten geeignet für | Orchestrierung, geführte Benutzeroberflächen, Benachrichtigungen, häufig wechselnde Logik | Stabile Kernlogik, Integrationen, Datenverarbeitung, wiederverwendbare Dienste | Ziehen Sie Apex von Anfang an gemeinsam mit Flow in Betracht, nicht erst, wenn die deklarativen Möglichkeiten ausgeschöpft sind. |
Wartbarkeit | Gut, solange die Flows klein und klar bleiben | Gut bei klarer Architektur und Struktur | Die Wartbarkeit hängt stärker von der Disziplin in der Softwareentwicklung ab als von der Frage, ob visuell oder mit Code gearbeitet wird. |
Technische Kompetenzen | Niedrige Einstiegshürde | Höhere Einstiegshürde | Low-Code macht systematisches, ingenieurmäßiges Denken nicht überflüssig. |
Tests | Tests sind möglich, lassen sich aber leichter auslassen | Unit-Tests sind fester Bestandteil der regulären Apex-Entwicklung | Flow sollte wie Code behandelt werden, mit Tests, die Fehler vor der Bereitstellung erkennen. |
Komplexe Verarbeitung | Abfragen, Schleifen, Zuordnungen und Gruppierungen können schwer zu verwalten sein | In der Regel einfacher direkt auszudrücken | Nur weil Flow etwas umsetzen kann, ist es nicht zwangsläufig die beste Möglichkeit, den Algorithmus auszudrücken. |
Code-Review | Visuell leicht verständlich, als XML schwieriger zu prüfen | In der Versionsverwaltung unkompliziert zu prüfen | Ein Flow kann schwieriger zu prüfen sein als Apex, sobald Git und reguläre Entwicklungsprozesse zum Einsatz kommen. |
KI-gestützte Entwicklung | Meiner Erfahrung nach arbeiten LLMs mit Flow-Metadaten weniger zuverlässig | Meiner Erfahrung nach sind LLMs bei Apex sehr leistungsfähig | KI hat die bisherigen Nachteile von Apex bei Entwicklung und Wartung erheblich verringert. |
Governance | Kann durch doppelte und inaktive Automatisierungen unübersichtlich werden | Kann durch schlechte Architektur unübersichtlich werden | Das Problem ist nicht das Tool, sondern die Art, wie Sie es einsetzen. |
Zusammenspiel | Starke Orchestrierungsschicht | Starker, wiederverwendbarer Kern | Flow und Apex können einander ergänzen, statt als strikt getrennte Alternativen behandelt zu werden. |
Eine Zusammenfassung aus der Praxis dazu, wo Flow und Apex in modernen Salesforce-Implementierungen ihren Platz haben.