 English
 Suomi
 Français
 Deutsch
Chcesz zautomatyzować rutynowe zadania?
Skontaktuj się z nami, aby już dziś poprawić doświadczenia klientów i zwiększyć produktywność.
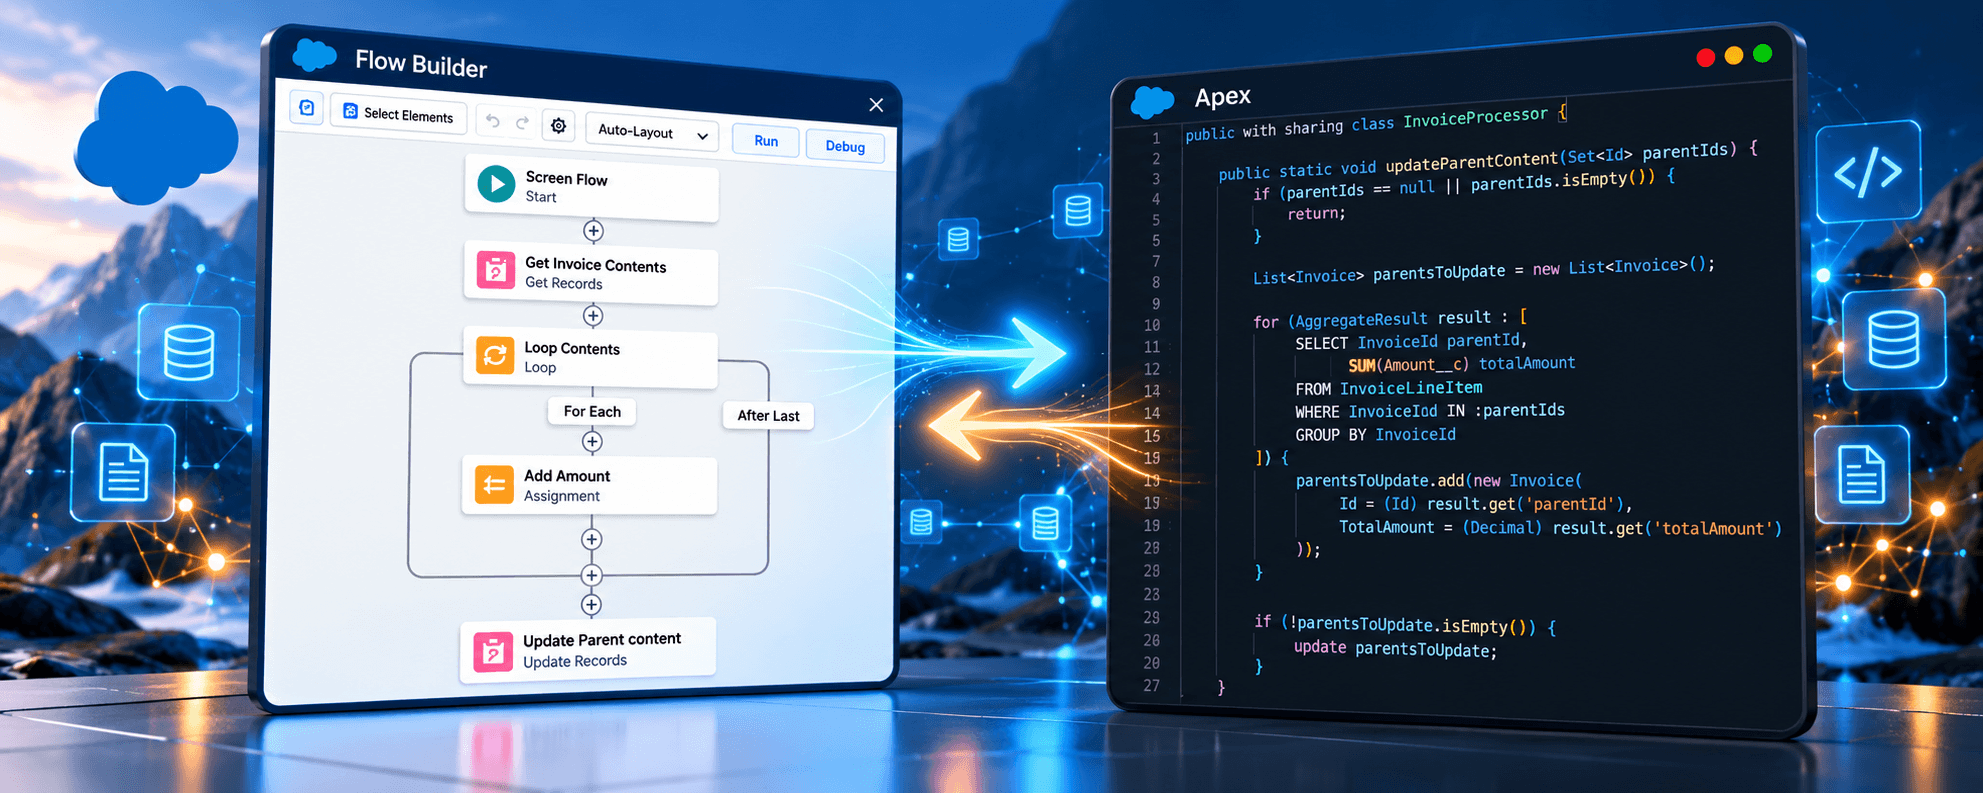
Ostatnio zastanawiałem się, dlaczego Flow nadal jest uznawany niemal za pierwszy wybór przy wdrażaniu czegoś w Salesforce.
Flow jest dostępny od razu. Jest wizualny i uporządkowany. Ma piękne kolory. Przedstawia się go jako narzędzie, które mogą utrzymywać administratorzy. Z kolei Apex często zarzuca się ogromną złożoność, bardzo duży stopień dostosowania, wysokie koszty wdrożenia i trudności w utrzymaniu.
W wielu artykułach porównujących Flow i Apex to Flow jest domyślnie przedstawiany jako lepsza opcja. Powtarzają się te same zalety: jest prostszy, łatwiejszy w utrzymaniu, wymaga mniejszych umiejętności technicznych i ogólnie stanowi zalecane rozwiązanie.
Zacząłem się zastanawiać, czy to stanowisko nadal jest aktualne. Dzięki narzędziom do programowania z użyciem AI i vibe codingu wiele dawnych argumentów przeciwko Apex nie jest już tak mocnych jak wcześniej. Jednocześnie uważam, że Flow często przedstawia się jako znacznie prostszy, niż jest w rzeczywistości.
Moja główna teza jest prosta: Apex nie jest aż tak trudny, a przepływy nie są aż tak łatwe. Ich poziom złożoności jest znacznie bardziej zbliżony, niż zwykle się zakłada.
Zacznijmy od przepływów. Przepływy mają wiele struktur, które znajdziemy w Apex: iteracje, zapytania, akcje, warunki, przypisania i tak dalej.
Zasadniczo potrzebna jest wiedza o tym, jak tworzyć aplikacje i algorytmy. Przepływ jest algorytmem, tak samo jak kod.
Od strony technicznej Flow jest reprezentacją tego algorytmu w XML, natomiast Apex jest językiem programowania, który również reprezentuje algorytm. W obu przypadkach algorytm staje się zrozumiały dla maszyny, która go wykonuje.
Czy logika Flow jest prosta? Niezupełnie. Logika Flow jest przedstawiona wizualnie.
Ta wizualna reprezentacja sprawia, że ludzie uważają Flow za prostszy od Apex. Moim zdaniem ta prostota może być myląca.
W Flow można osiągnąć wiele z tego, co można osiągnąć w Apex, a oba narzędzia można łączyć za pomocą akcji wywoływalnych. W wielu przypadkach służą temu samemu celowi i są uruchamiane w podobny sposób, między innymi przy aktualizacji rekordów, zgodnie z harmonogramem czy w wyniku działań użytkownika w Salesforce.
Pod względem złożoności przepływy mogą wydawać się prostsze, ponieważ są diagramami wizualnymi, a Apex wymaga umiejętności czytania kodu. Do Flow należy jednak podchodzić równie starannie jak do Apex. Na początek polecamy nasze omówienie Salesforce Flow Builder.
Stwierdzenie, że do utrzymania automatyzacji wystarczy zespół administratorów, może być prawdziwe — ale pod jednym ważnym warunkiem. Osoby utrzymujące Flow powinny wiedzieć, jak tworzyć algorytmy.
Potrzebują sposobu myślenia, który pozwala im budować algorytmy krok po kroku, uwzględniać rozwiązania awaryjne na wypadek błędów, przewidywać, co może pójść nie tak, i zastanawiać się nad przyszłymi wymaganiami. Potrzebują też sposobu na automatyczne testowanie tej funkcjonalności.
Od każdej osoby wdrażającej takie automatyzacje oczekiwałbym systematycznego myślenia i zrozumienia, jak tworzyć algorytmy, systemy i aplikacje.
Trzeba umieć rozważyć, jakie dane wejściowe są nieprawidłowe dla danego algorytmu, jakich wyników się oczekuje, które błędy można obsłużyć, a których nie.
Low-code nie eliminuje potrzeby myślenia w kategoriach inżynierii oprogramowania. Kod generowany przez AI również jej nie eliminuje.
Flow świetnie się sprawdza, gdy automatyzacja jest prosta. Jeśli wymaganie brzmi: „Gdy moja szansa sprzedaży uzyska status Closed Won, wyślij powiadomienie e-mail”, to tak — można bez problemu utrzymywać takie rozwiązanie w Flow.
Jeśli potrzebujesz procesu, który prowadzi pracowników krok po kroku przez interfejs, Flow również świetnie się sprawdzi. Jeśli dziś chcesz wysłać e-mail promocyjny, utworzyć przepływ na potrzeby kampanii, a za trzy miesiące go wyłączyć lub zmienić, Flow będzie dobrym rozwiązaniem. To właśnie jego mocna strona.
Jeśli jednak potrzebujesz czegoś bardziej złożonego — na przykład znalezienia wszystkich potencjalnych klientów, u których wartość pola Company przypomina nazwę właśnie przekonwertowanego konta, a następnie przekonwertowania tych potencjalnych klientów — to już inna historia.
Moja osobista praktyczna zasada jest taka: jeśli w przepływie jest więcej niż około dziesięciu elementów, zaczynam mu się uważniej przyglądać. Jeśli przepływ łączy iteracje z zapytaniami albo wymaga wyszukiwania, zbierania, mapowania, grupowania czy analizowania rekordów, to moim zdaniem staje się już złożony. Nie jest to oficjalna dobra praktyka Salesforce. To po prostu moja osobista praktyczna zasada.
Na tym etapie, zwłaszcza przy użyciu kodu generowanego przez AI, osiągnięcie tego samego w Apex może być znacznie łatwiejsze. Unikałbym umieszczania logiki w Flow, gdy muszę mapować jedną wartość rekordu na inną, analizować lub grupować rekordy, przetwarzać dane masowo albo obsługiwać logikę obejmującą wiele transakcji.
Nie dlatego, że Flow tego nie potrafi. Potrafi. Ale sam fakt, że można coś zbudować w Flow, nie oznacza, że Flow jest najlepszym sposobem wyrażenia danego algorytmu. Bardzo rozbudowany przepływ można czasem zastąpić niewielką ilością kodu Apex.
Kiedy mówię, że zaawansowani użytkownicy mogą ponieść sromotną porażkę przy pracy z Flow, nie mam na myśli tego, że Flow jest zły. Chodzi o sposób korzystania z narzędzia. Problem znajduje się między klawiaturą a krzesłem.
Można spotkać wdrożenia, w których w organizacji Salesforce nagromadziło się wiele aktywnych i dezaktywowanych przepływów, nieużywanych pól oraz zduplikowanych pól, przepływów i fragmentów logiki. System może nadal działać, ale każdy nowy błąd lub problem zwiększa koszty utrzymania takiego rozwiązania.
W przeciwieństwie do Apex przepływy nie wymagają obowiązkowych testów jednostkowych. Owszem, można tworzyć testy obejmujące logikę automatyzacji Flow, ale nie jest to obowiązkowe — a to, co nie jest obowiązkowe, często się pomija.
Nie chodzi o to, że Flow nie da się testować. Chodzi o to, że Flow może stwarzać złudzenie, iż ze względu na swoją wizualną formę w jakiś sposób nie jest kodem i nie wymaga takiej samej dyscypliny.
Należy traktować go jak kod. Standardy nazewnictwa, porządkowanie, kontrola wersji, testowanie, przeglądy przez inne osoby z zespołu i proces wdrażania — wszystko to powinno być częścią pracy.
Inaczej jest w Apex, gdzie testy są obowiązkowe przy wdrażaniu na produkcję i trzeba osiągnąć wymagany próg pokrycia kodu testami. Przepływ można wdrożyć bez testów automatycznych. Nie chodzi o to, że Flow nie da się testować, lecz o to, że łatwiej pominąć testy, gdy platforma ich nie wymaga.
Z perspektywy przeglądu przez inne osoby z zespołu Flow może być wręcz trudniejszy do oceny niż Apex. Gdy otworzę kod Apex w GitHub, nawet programista Java może dostrzec duplikację, ogromne metody, słabą architekturę, skomplikowane warunki i pętle czy niejasny podział odpowiedzialności.
W przypadku XML przepływu jest to znacznie trudniejsze. Nawet programiści Salesforce nie są w stanie rzetelnie ocenić przepływu w GitHub na podstawie samego XML — muszą otworzyć jego wizualną reprezentację. Choć więc Flow wygląda prosto w Salesforce, może być mniej przejrzysty z perspektywy kontroli wersji i przeglądu kodu.
Nie próbuję powiedzieć, że Apex powinien teraz stać się domyślnym sposobem tworzenia wszystkich automatyzacji w Salesforce. Rozważam tezę, że Apex ma znacznie więcej zalet niż, powiedzmy, sześć lat temu.
Wiele argumentów tradycyjnie wysuwanych przeciwko Apex — złożoność, koszt wdrożenia i koszt utrzymania — nie jest już tak mocnych jak wcześniej. Głównym powodem są narzędzia do programowania z użyciem AI.
Apex przypomina Java i C#. Osoby preferujące C# znajdą w nim wiele podobieństw do C#, a osoby preferujące Java również poczują się znajomo. Podobieństwo języka programowania do tak powszechnie używanych języków staje się zaletą.
Istnieje mnóstwo kodu napisanego w Java, C#, JavaScript, HTML i wielu innych technologiach. Współczesne duże modele językowe bardzo dobrze radzą sobie z tymi językami, a z mojego doświadczenia wynika, że również z Apex i Lightning Web Components.
Podejrzewam, że jest to również jeden z powodów, dla których duże modele językowe (LLM) znacznie gorzej radzą sobie z metadanymi Flow: danych treningowych dotyczących XML Salesforce Flow jest mniej, a w publicznych repozytoriach GitHub trudno znaleźć wiele przepływów. To moje przypuszczenie, a nie coś, co potrafię udowodnić.
Z mojego doświadczenia wynika, że modele LLM znacznie lepiej generują kod Apex niż metadane Flow od podstaw. W przypadku Flow widziałem nieudane próby, w których model upraszczał zadanie, tworzył wiele akcji wywoływalnych i pozostawiał przepływ pełniący niewiele więcej niż funkcję punktu wejścia. Widziałem też wygenerowany XML, którego nie dało się poprawnie wdrożyć w Salesforce.
Modyfikowanie istniejącego przepływu jest dla modelu LLM łatwiejsze niż tworzenie czegoś nowego w pustej organizacji Salesforce, ale nawet wtedy może on popełniać błędy.
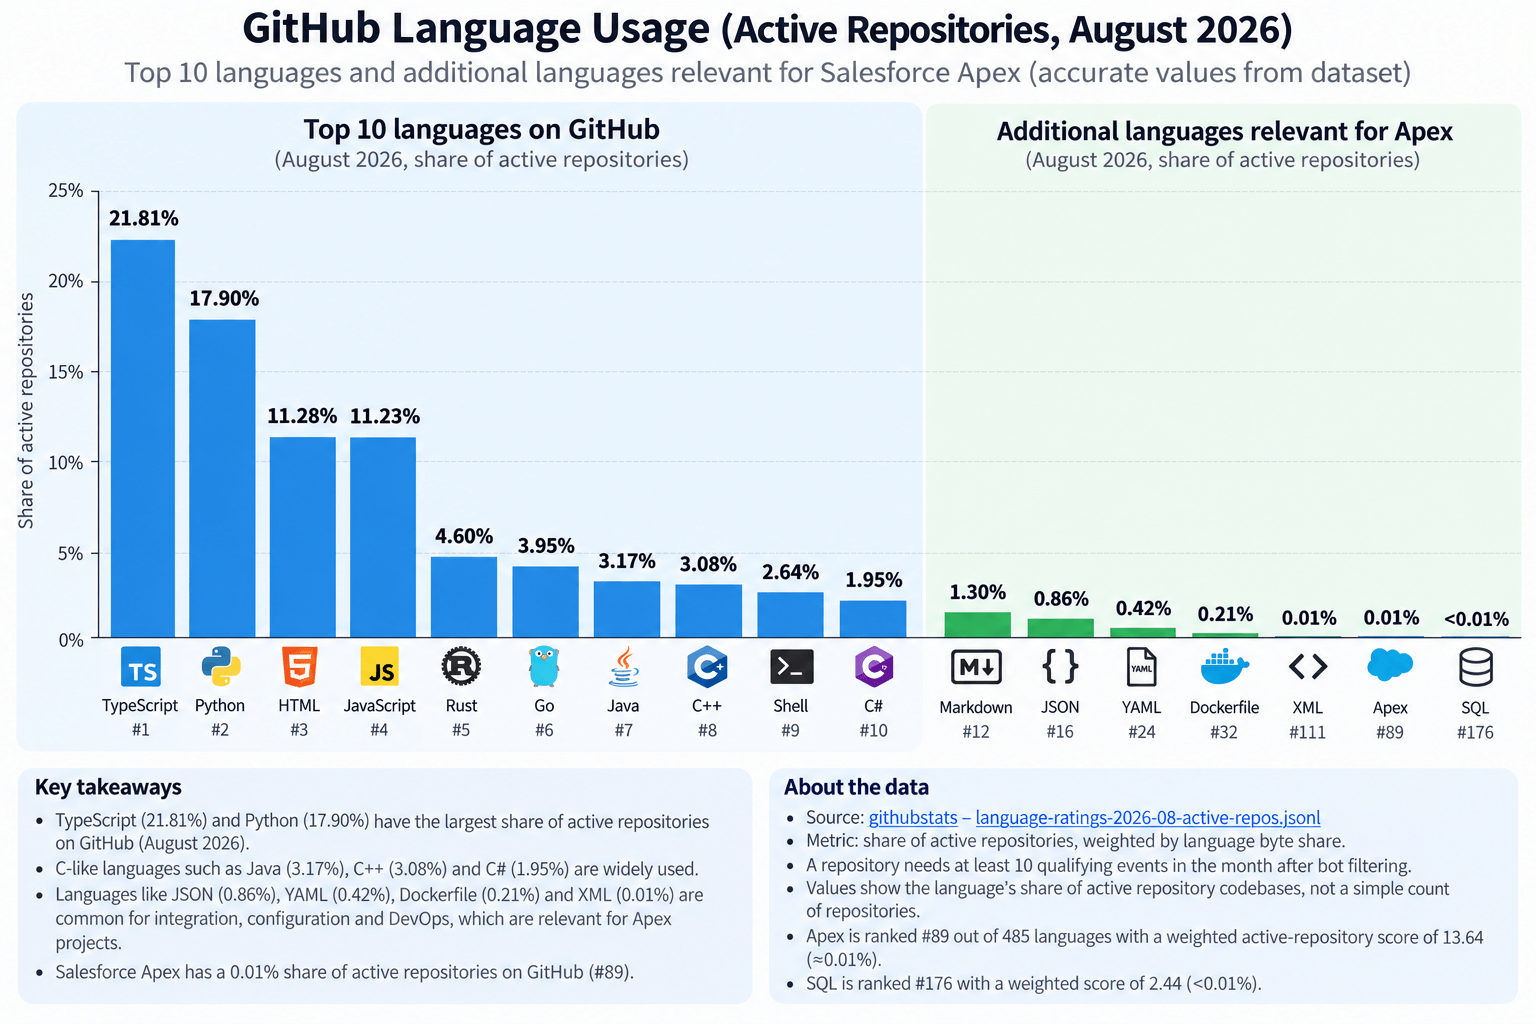
W porównaniu z najpopularniejszymi językami Apex stanowi bardzo niewielką część aktywnych publicznych repozytoriów GitHub. Pomaga to zobrazować różnicę w ilości publicznie dostępnego kodu, ale samo w sobie nie dowodzi, że model LLM lepiej radzi sobie z Apex lub gorzej z metadanymi Flow.
Dzięki narzędziom takim jak Codex, Claude Code czy OpenCode programiści mogą teraz podłączyć model LLM bezpośrednio do projektu programistycznego lub bazy kodu Salesforce.
Model LLM może znajdować konkretne części bazy kodu, identyfikować problemy i błędy, śledzić logikę oraz generować zmiany znacznie szybciej, niż programista zrobiłby to ręcznie. Samo generowanie kodu również jest bardzo szybkie, co oznacza, że programiści mogą znacznie szybciej tworzyć rozwiązania i rozwijać je iteracyjnie.
Nie eliminuje to jednak potrzeby posiadania wiedzy inżynierskiej.
Programiści, którzy rozumieją, jak należy projektować rozwiązania w Salesforce, mogą ukierunkować model LLM na właściwe decyzje architektoniczne, podejścia do wdrożenia i wzorce programistyczne. W rezultacie mogą tworzyć przejrzysty, działający kod bez poświęcania takiej samej ilości czasu na samodzielne pisanie wszystkiego.
Pracę, która wcześniej mogła zająć miesiąc, dziś można czasem ukończyć w kilka dni.
Różnica nie dotyczy wyłącznie szybkości.
Programiści mogą poświęcać więcej czasu temu, co naprawdę istotne: kluczowej logice, architekturze, przypadkom brzegowym, doświadczeniu użytkownika i łatwości utrzymania. Mogą ulepszać interfejs, obejmować testami więcej scenariuszy i wprowadzać dodatkowe usprawnienia, zamiast z nich rezygnować, ponieważ wymagałyby zbyt wielu godzin pracy, by zmieścić się w budżecie.
Model LLM znacznie przyspiesza wdrożenie, ale jakość nadal zależy od kierującego nim programisty. Programiści wciąż muszą rozumieć, jak powinna wyglądać prawidłowa architektura Salesforce, jakie wzorce stosować i na jakie kompromisy się decydują.
W zasadzie nie piszę już kodu samodzielnie, ale też nie akceptuję bezrefleksyjnie tego, co generuje agent AI. Biorę pełną odpowiedzialność za to, co wygeneruje.
Mój przegląd nie ogranicza się do sprawdzania kodu wiersz po wierszu. Najpierw definiuję architekturę: jak ma wyglądać, z jakiego frameworka ma korzystać i jakie podejście ma realizować. Następnie sprawdzam wygenerowany kod pod kątem błędów architektonicznych, nadmiernej złożoności, duplikacji, problemów ze skalowaniem i rzeczy, które po prostu nie mają sensu.
Najważniejsze nie jest ręczne sprawdzanie każdego wiersza. Najważniejsze jest zrozumienie, jakiej architektury oczekujemy, zanim rozpocznie się wdrożenie.
Jeśli na przykład obliczenie agregujące sumuje godziny poświęcone na projekt lub zgłoszenie, być może z podziałem na osoby, muszę uwzględnić rekurencję. Umieszczenie go w logice aktualizacji pól może powodować kolejne, rekurencyjne aktualizacje. Może to prowadzić do uciążliwych wyjątków SOQL 101 lub przekroczenia limitu CPU w Salesforce.
Agent AI może wygenerować coś, co działa na dziesięciu rekordach. Nie oznacza to, że będzie działać poprawnie przy dużym wolumenie danych. Ale jako osoba, która rozumie, co należy zrobić, mogę pokierować agentem AI.
Możemy korzystać z frameworków do obsługi wyzwalaczy i przekazywać flagi. W niektórych przypadkach, gdy obliczamy podsumowania zbiorcze, nie musimy ponownie uruchamiać wyzwalaczy. W ten sposób możemy zbudować infrastrukturę łatwą w utrzymaniu. To właśnie tutaj wiedza inżynierska nadal ma znaczenie.
Gdy struktura jest już ustalona, wprowadzanie kolejnych aktualizacji staje się znacznie łatwiejsze. Łatwiejsze stają się poprawki błędów, dodawanie nowych funkcji i refaktoryzacja, a w wielu przypadkach pracę można powierzyć konsultantowi lub administratorowi.
Łącząc AI z umiejętnościami programisty, możemy znacznie zwiększyć produktywność pracy z Apex i Lightning Web Components (LWC).
Na przykład przy użyciu LWC OpenAI Codex może tworzyć imponujące aplikacje w Salesforce. W niektórych projektach nie chcę przenosić do danych Salesforce wszystkich prac, zgłoszeń czy wpisów czasu pracy. Mogę zamiast tego zbudować elastyczne widoki list powiązanych z rekordami, które uwzględniają brak danych w Salesforce i pobierają informacje przez API.
AI przydaje się również przy drobnych szczegółach interfejsu, takich jak umieszczenie wskaźnika ładowania wewnątrz przycisku. Wiem, że CSS i HTML to moje słabe strony; nie lubię dopracowywać funkcji interfejsu i animacji. Codex bez problemu radzi sobie z tą pracą, podczas gdy ja skupiam się na tym, co widzę, i opisuję, co należy zmienić.
To nadal nie daje jednoznacznej odpowiedzi na pytanie, które narzędzie powinno być głównym narzędziem automatyzacji w Salesforce. Moim zdaniem Apex można wykorzystywać do tworzenia kluczowej logiki.
Przez kluczową logikę rozumiem logikę, która stanowi podstawę działania organizacji i obejmuje główne procesy biznesowe we wdrożeniu Salesforce. Mogą to być akcje dostępne dla pracowników, na przykład akcje wywoływalne dla przepływów. Mogą to być integracje napisane w Apex. Mogą to być operacje na danych.
Na przykład po przekonwertowaniu potencjalnego klienta na konto mogę chcieć znaleźć firmy o podobnych nazwach, zidentyfikować powiązane kontakty i również je przekonwertować. Mogę też potrzebować lepszego sposobu uruchamiania zadań zgodnie z harmonogramem. Są to kluczowe operacje, które mogą obsługiwać całe procesy biznesowe.
Mówiąc o integracjach, mam na myśli bezpośrednie integracje przez API z poziomu Salesforce, gdy nie ma dostępnego konektora i nie wdrożono jeszcze innego narzędzia integracyjnego, takiego jak MuleSoft, Talend czy Jitterbit. Apex bardzo dobrze nadaje się do obsługi takiej logiki.
Flow wykorzystywałbym raczej do orkiestracji i elastycznego wprowadzania zmian: do czegoś, co zmienia się stosunkowo często lub co do czego nie ma pewności, że będzie potrzebne na zawsze. Można na przykład chcieć wysłać e-mail, gdy potencjalny klient osiągnie określony etap, uruchomić tymczasową kampanię promocyjną albo udostępnić pracownikom proces prowadzący ich krok po kroku przez interfejs. Tutaj Flow naprawdę się sprawdza.
Flow i Apex bardzo dobrze sprawdzają się również razem. Kluczową logikę można umieścić w Apex, używać przepływów uruchamianych przed zapisem i po zapisie do modyfikowania lub koordynowania działania, a funkcjonalność Apex udostępniać za pomocą akcji wywoływalnych. Nie postrzegam tego jako ścisłej rywalizacji Flow z Apex. Mogą się bardzo dobrze uzupełniać.
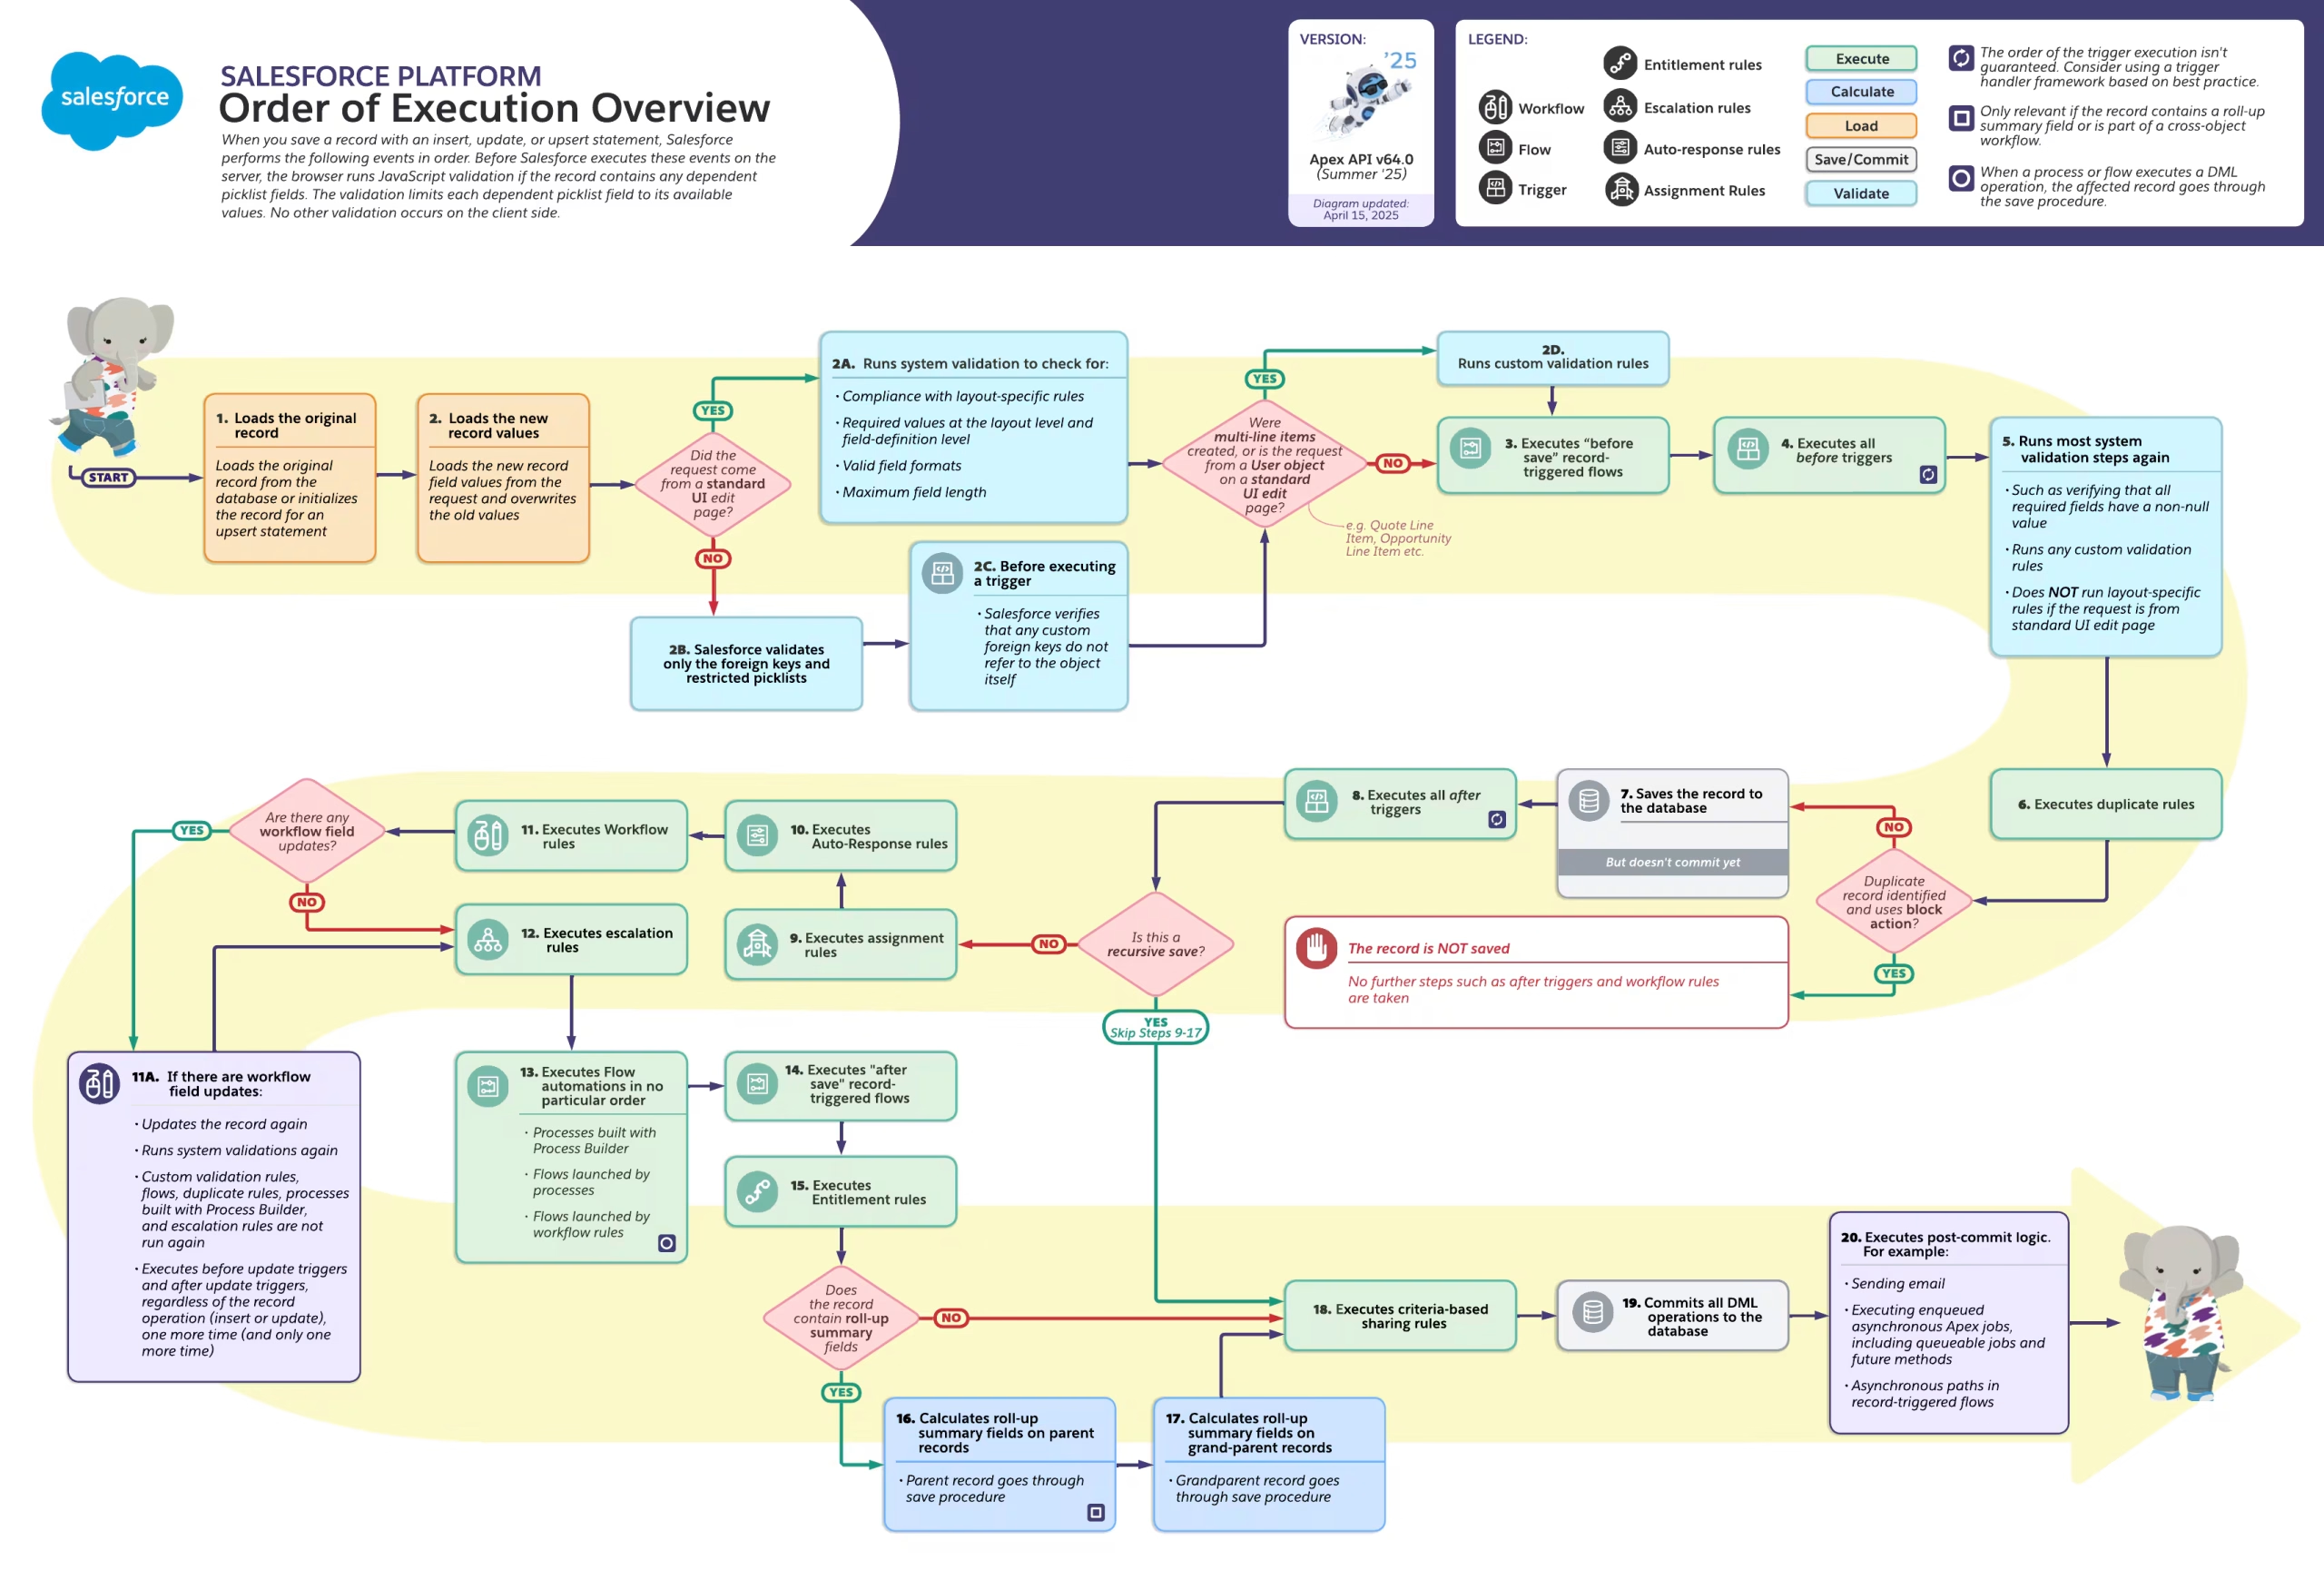
Kolejność wykonywania operacji w Salesforce pokazuje, jak przepływy, wyzwalacze, walidacja, podsumowania zbiorcze, operacje na bazie danych i działania po zatwierdzeniu transakcji uczestniczą w tym samym cyklu życia rekordu.
Kolejnym ważnym tematem jest zarządzanie zmianami. Dotyczy ono nie tylko Apex, lecz całej warstwy metadanych Salesforce. Flow również stanowi metadane Salesforce. Należy traktować go jak kod, nawet gdy jest przedstawiony w postaci wizualnego diagramu.
Należy zadbać o bezpieczne środowisko do tworzenia rozwiązań, osobne środowisko do testów, a następnie środowisko produkcyjne. Produkcja jest niczym Święty Graal: obserwujesz ją i w niej pracujesz, ale tam nie eksperymentujesz.
Widzę wiele rozwiązań budowanych bezpośrednio na produkcji. To większy problem niż to, czy ktoś użył Flow, czy Apex.
W idealnym świecie można korzystać ze środowisk scratch org. Jeśli rozpoczynasz wdrożenie od zera, scratch org to dobry punkt wyjścia. Kluczową funkcjonalność można umieścić w pakiecie zarządzanym lub niezarządzanym, wdrożyć go i uruchomić skrypt inicjalizujący dane testowe. Tworzenie takich skryptów inicjalizacyjnych również jest łatwym zadaniem dla modeli LLM.
Masz wtedy środowisko zapewnienia jakości, w którym możesz testować logikę na fikcyjnych danych spoza produkcji. Dzięki temu nie musisz obawiać się wysłania rzeczywistym klientom fikcyjnej faktury lub e-maila o nieistniejącym rabacie.
Po przetestowaniu wdrażasz ten sam kod źródłowy lub pakiet na produkcję. Stosowane rozwiązania mogą być różne — scratch org, środowiska sandbox Salesforce, pakiety czy CI/CD. To kwestia drugorzędna. Ważne, by środowiska programistyczne, testowe i produkcyjne pozostawały oddzielone.
Nie twierdzę, że wszyscy powinni przestać korzystać z Flow i przejść na Apex. Nie uważam, że Apex powinien wszędzie stać się domyślnym wyborem.
Twierdzę natomiast, że Apex ma znacznie więcej zalet niż sześć lat temu. Argumenty przeciwko Apex — koszt, złożoność i utrzymanie — są dziś słabsze, ponieważ narzędzia do programowania z użyciem AI zmieniły ekonomię tworzenia oprogramowania.
Jednocześnie Flow nigdy nie był tak prosty, jak go przedstawiano. Flow to nadal programowanie. Wciąż wymaga myślenia algorytmicznego, architektury, testowania, zarządzania zmianami i inżynierii oprogramowania.
Nie uważam już zasady „używaj Flow, chyba że bezwzględnie potrzebujesz Apex” za dobrą zasadę domyślną. Nie sądzę też, by „używaj Apex wszędzie” było dobrą odpowiedzią. Każde wdrożenie to odrębny przypadek.
Trzeba wziąć pod uwagę to, co budujesz. Prowadzisz małą czy dużą firmę? Jak dużego dostosowania potrzebujesz? Jak stabilna jest logika? Kto będzie ją utrzymywał? Jakimi kompetencjami inżynierskimi dysponujesz? Jak często logika będzie się zmieniać? Z jakim wolumenem danych masz do czynienia? Dopiero wtedy podejmujesz decyzję.
Osobiście do stabilnej, kluczowej logiki wielokrotnego użytku skłaniam się raczej ku Apex. W przypadku orkiestracji, procesów prowadzących użytkownika przez interfejs, powiadomień i elastycznych zmian — raczej ku Flow.
Gdy przepływ zaczyna stawać się rozbudowanym algorytmem z pętlami, zapytaniami, grupowaniem, mapowaniami i skomplikowaną logiką, przynajmniej zatrzymałbym się i ponownie rozważył, czy nadal powinien być przepływem.
To nie jest uniwersalna zasada. To dyskusja — a dziś jest ona znacznie ciekawsza niż proste stwierdzenie, że Flow jest łatwy, a Apex trudny.
Obszar | Flow | Apex | Moje spojrzenie / obalanie mitów |
|---|---|---|---|
Test prostoty | Wizualny i przystępny | Wymaga czytania kodu | Flow wydaje się prostszy, ponieważ jest wizualny, ale kryjąca się za nim logika może być równie złożona. |
Najlepsze zastosowania | Orkiestracja, interfejs prowadzący użytkownika krok po kroku, powiadomienia, często zmieniająca się logika | Stabilna kluczowa logika, integracje, przetwarzanie danych, usługi wielokrotnego użytku | Rozważaj Apex razem z Flow od samego początku, a nie dopiero po wyczerpaniu możliwości deklaratywnych. |
Łatwość utrzymania | Dobra, dopóki przepływy pozostają niewielkie i czytelne | Dobra, gdy architektura i struktura są przejrzyste | Łatwość utrzymania zależy bardziej od dyscypliny inżynierskiej niż od tego, czy korzystamy z narzędzi wizualnych, czy z kodu. |
Umiejętności inżynierskie | Niski próg wejścia | Wyższy początkowy próg wejścia | Podejście low-code nie eliminuje potrzeby systematycznego myślenia inżynierskiego. |
Testowanie | Testy są dostępne, ale łatwiej je pominąć | Testy jednostkowe są integralną częścią standardowego procesu programowania w Apex | Flow należy traktować jak kod i stosować testy, które wykrywają błędy przed wdrożeniem. |
Złożone przetwarzanie | Zapytania, pętle, mapowania i grupowanie mogą stać się trudne w zarządzaniu | Zwykle łatwiej wyrazić je bezpośrednio w kodzie | To, że Flow potrafi coś zrobić, nie oznacza, że jest najlepszym sposobem na wyrażenie danego algorytmu. |
Przegląd kodu | Łatwo zrozumieć w formie wizualnej, trudniej przeanalizować w formacie XML | Łatwy przegląd w systemie kontroli wersji | Po przejściu na Git i standardowe procesy programistyczne przegląd Flow może okazać się trudniejszy niż przegląd kodu Apex. |
Programowanie z pomocą AI | Z mojego doświadczenia wynika, że modele LLM są mniej niezawodne w pracy z metadanymi Flow | Z mojego doświadczenia wynika, że modele LLM bardzo dobrze radzą sobie z Apex | AI w dużej mierze zniwelowała dotychczasowe słabsze strony Apex pod względem tworzenia i utrzymania rozwiązań. |
Nadzór | Powielone i nieaktywne automatyzacje mogą prowadzić do bałaganu | Zła architektura może prowadzić do bałaganu | Problemem nie jest narzędzie, lecz sposób, w jaki go używasz. |
Wspólne zastosowanie | Solidna warstwa orkiestracji | Solidny rdzeń wielokrotnego użytku | Flow i Apex mogą się wzajemnie uzupełniać, zamiast być traktowane jako rozwiązania wzajemnie się wykluczające. |
Podsumowanie z perspektywy praktyka: miejsce Flow i Apex we współczesnych wdrożeniach Salesforce.